L09|Stable Diffusion 入門
Part 2 第一課:先用 Diffusers 函式庫玩轉 Stable Diffusion,再拆解它的四個核心元件與背後直覺。
L09|Stable Diffusion 入門(Stable Diffusion)
零基礎提示
- 這一課不用額外數學
- Part 2 是大學程度:中三同學先求看懂概念,不用每行程式都會
- 字幕:離線網站選「中英」(電腦翻譯,大意正確)
- 看不懂的詞查 白話小辭典
Part 2 第一課:先用 Diffusers 函式庫玩轉 Stable Diffusion,再拆解它的四個核心元件與背後直覺。 (Part 2 opens by using the Diffusers library for Stable Diffusion, then breaks down its four core components and the intuition behind them.)
| 項目 | 內容 |
|---|---|
| 所屬 | Part 2:Deep Learning Foundations to Stable Diffusion |
| 影片 | YouTube |
| 對應書本章節 | 無對應章節(Part 2 以 notebook 為主) |
| 原始頁面 | Lessons/lesson9 |
| 難度(F3 視角) | ★★★★★ 大學程度(F3 只求理解概念) |
影片
本課重點
- Part 2 怎麼學:每課是影片加 notebook,資源都在課程頁;內容是研究所等級,要投入大量時間;預設你已學完 Part 1;建議找讀書夥伴;部分課後挑戰屬於未知的研究方向。
- Diffusers 管線與技巧:用預訓練 pipeline 由文字生成圖片。guidance scale 調整提示詞的影響力;negative prompt 去除不要的概念;image-to-image 從現有圖片出發;textual inversion 和 Dreambooth 教模型認識新概念。
- 四個核心元件:CLIP 文字編碼器把提示詞變成向量;VAE 把圖片壓縮成較小的 latents;U-Net 預測圖片中的雜訊;scheduler 決定每一步去掉多少雜訊。
- 直覺:一步步把雜訊變成圖:想像一個模型能判斷「這張圖有多像手寫數字」,對每個像素的導數(梯度)告訴我們怎麼改圖才更像。反覆依梯度修正,就能從雜訊生成圖片。導數可以用有限差分慢慢算,也可以用解析導數一次算完。
- CLIP 與對比損失:同時訓練文字編碼器和圖片編碼器,讓配對的文字和圖片向量接近、不配對的遠離。課程最後指出擴散取樣和深度學習優化器很相似,暗示新的研究方向。
關鍵概念
| 英文術語 | 中文 | 一句話解釋 |
|---|---|---|
| Diffusion model | 擴散模型 | 學會一步步去除雜訊來生成圖片的模型 |
| Guidance scale | 引導強度 | 生成時提示詞影響力的大小 |
| Negative prompt | 負面提示詞 | 告訴模型不要出現的內容 |
| Latents | 潛在表示 | VAE 壓縮後較小的圖片表示 |
| U-Net | U 型網路 | 先縮小再放大、中間有捷徑連接的網路,用來預測雜訊 |
| CLIP | CLIP 模型 | 把文字和圖片放進同一個向量空間 |
| Finite differencing | 有限差分 | 稍微改一點輸入,看輸出變多少,來估計導數 |
認識關聯圖與重點圖

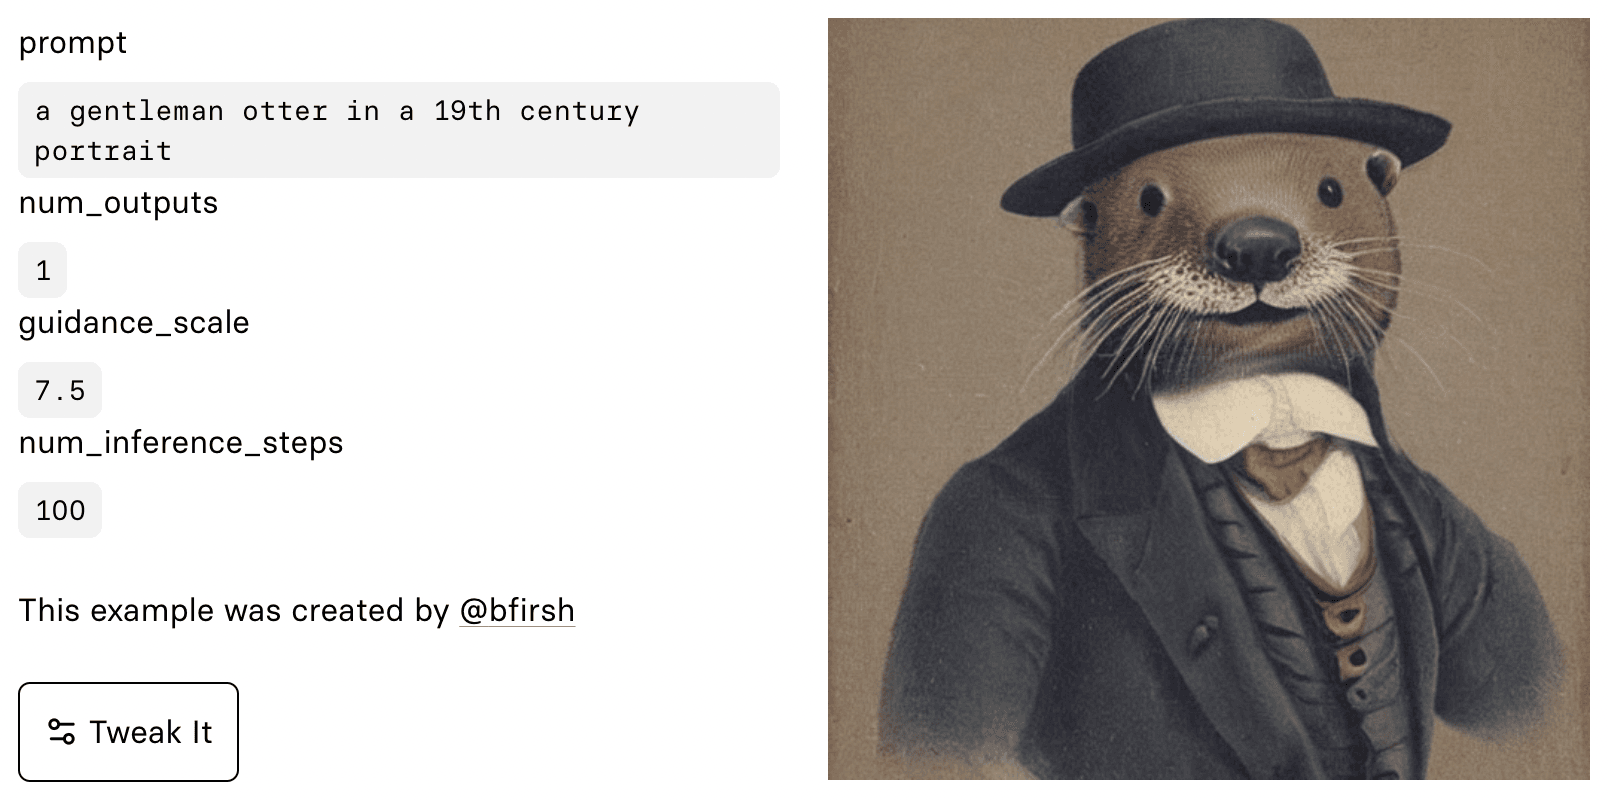
(Part 2 總覽頁的範例圖。)
Bonus 9A(Jonathan Whitaker 的深入解說)與 9B(擴散的數學)官方頁面目前 404,影片連結見下方資源。
練習題
- Stable Diffusion 的四個核心元件是什麼?各用一句話說明。
- guidance scale 調高和調低,生成的圖片會怎樣不同?
- 想生成「海灘上的狗」但不想出現人,你會怎樣寫 prompt 和 negative prompt?
- 中文學生作答:L09_中文F3學生_202611041526
- English student answers: L09_EN_F3_Student_202611041526
資源連結
英文延伸資源(零基礎可以先略過,點開看)
What you need to know
Lesson overview
Lesson resources
- accompanying notebook
- lesson notes
- Published version
- Free notebook version
- Sample full chapters
- Lesson Notes
Links from the lesson
- Discuss this lesson
- Course repo
- diffusion-nbs repo
- HuggingFace Notebooks
- Lambda Labs
- Paperspace Gradient
- Jarvis Labs
- vast.ai - crowdsourced GPU service
- Lexica
- PromptHero
- Hexo - 10M Images and Prompts
- Tools and Resources for AI Art
- fastai repo
Useful background on fast.ai courses
