L07|協同過濾:推薦系統與嵌入
推薦系統靠協同過濾,把「使用者 × 商品」矩陣中缺的格子填起來。這課也講梯度累積、多目標模型、softmax 與交叉熵、權重衰減。
L07|協同過濾:推薦系統與嵌入(Collaborative filtering)
推薦系統靠協同過濾,把「使用者 × 商品」矩陣中缺的格子填起來。這課也講梯度累積、多目標模型、softmax 與交叉熵、權重衰減。 (Recommendation systems use collaborative filtering to fill in missing cells of a user × item matrix. Also: gradient accumulation, multi-target models, softmax, cross-entropy and weight decay.)
| 項目 | 內容 |
|---|---|
| 所屬 | Part 1:Practical Deep Learning |
| 影片 | YouTube |
| 對應書本章節 | 第 8 章 Collab |
| 原始頁面 | Lessons/lesson7 |
| 難度(F3 視角) | ★★★★☆ 進階 |
影片
本課重點
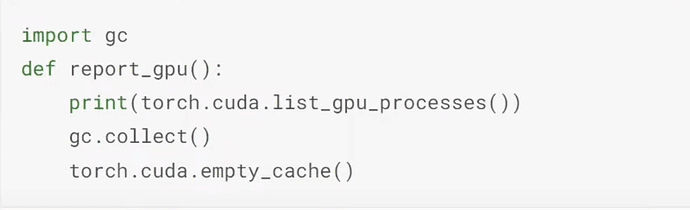
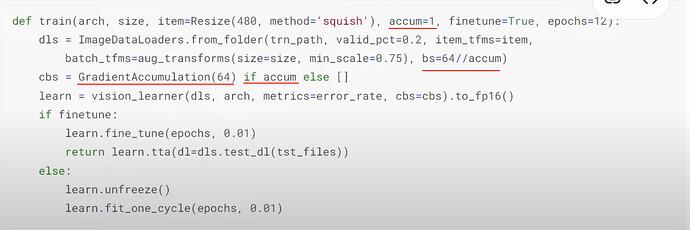
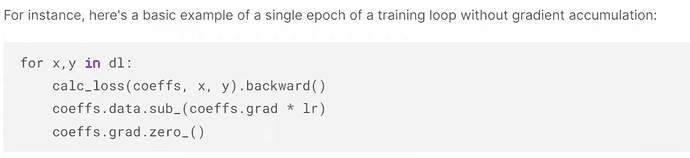
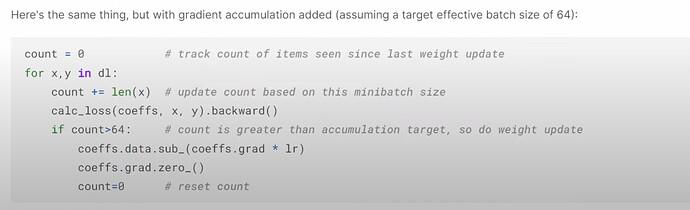
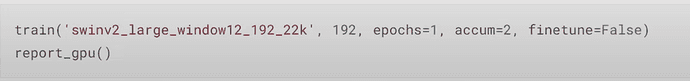
- 梯度累積:大模型會把 GPU 記憶體用光(CUDA out of memory)。GradientAccumulation 把一個批次拆成幾個小批次,累積梯度後才更新一次,結果幾乎等同於用大批次。
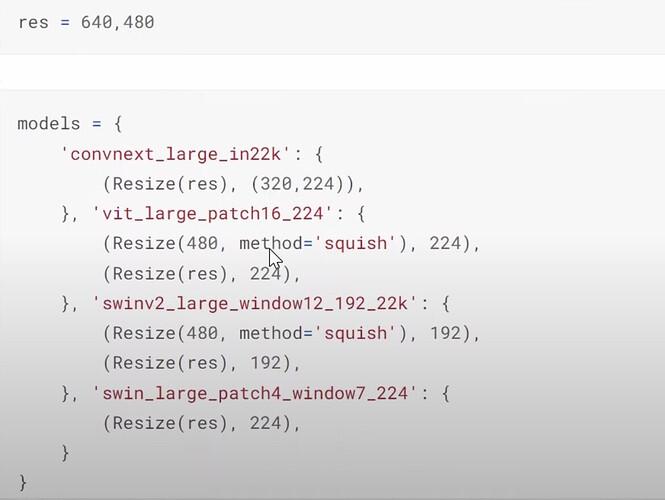
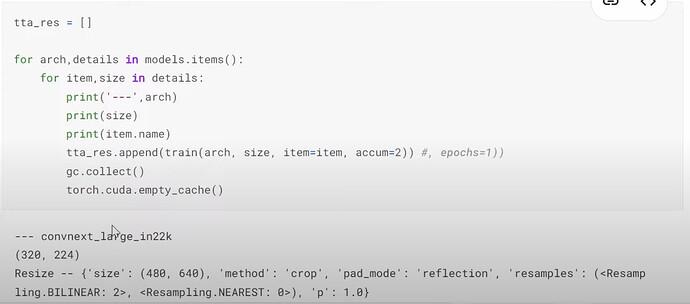
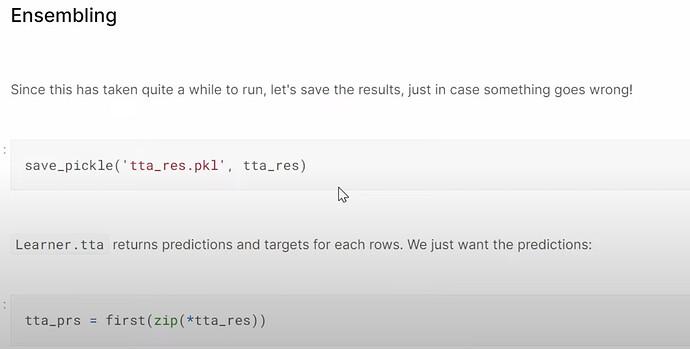
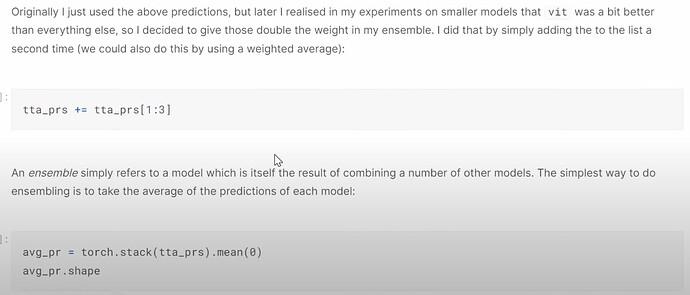
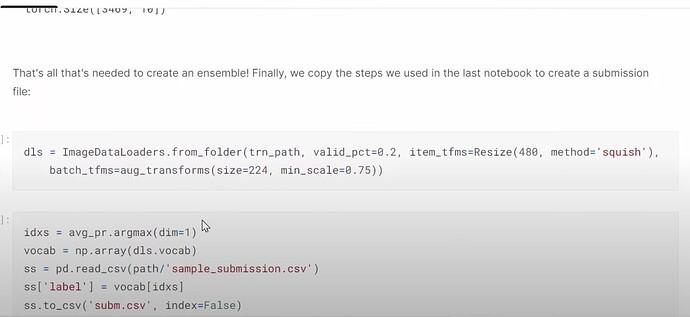
- 集成不同架構:把幾個不同的好架構(如 convnext、vit、swin)各自訓練,再平均預測,在稻米比賽中名列前茅。每天改進並提交,提交紀錄就是你的進度表。
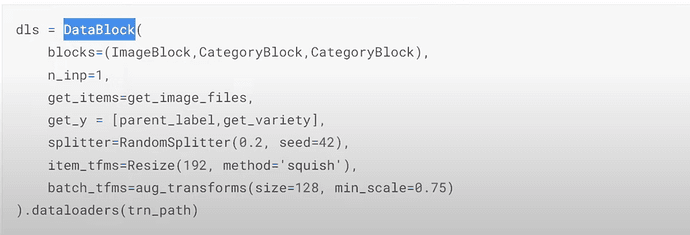
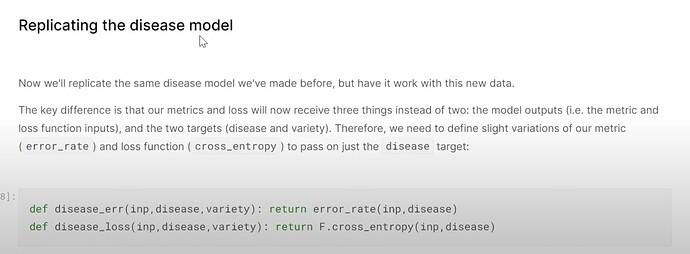
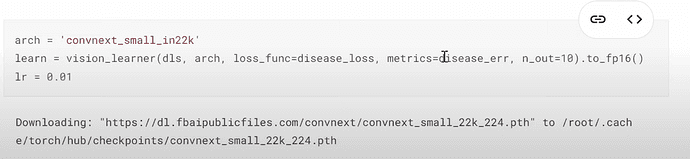
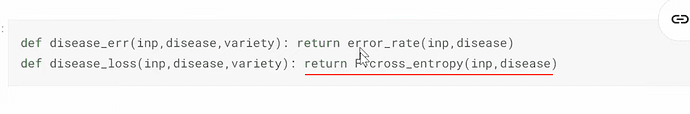
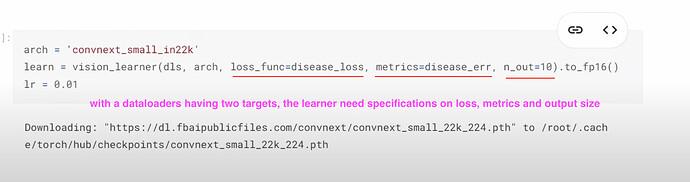
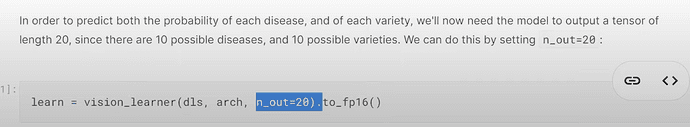
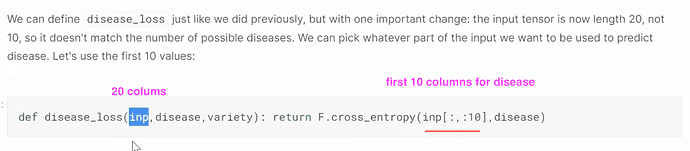
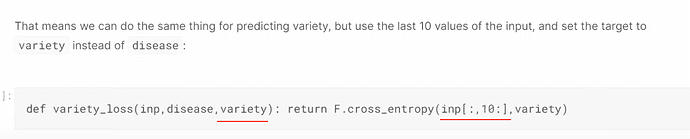
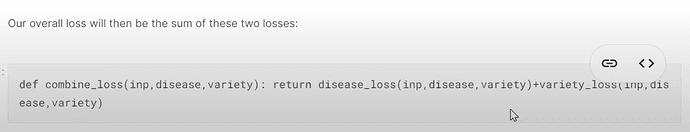
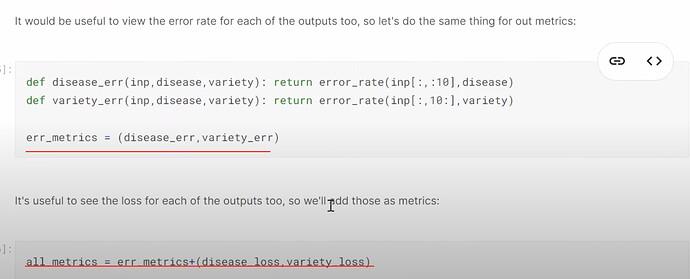
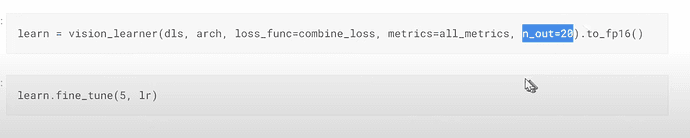
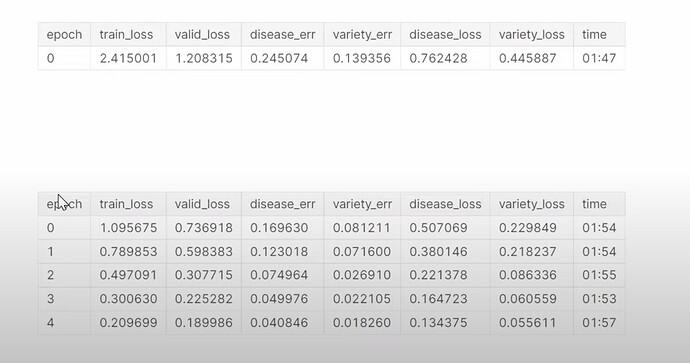
- 多目標模型:同一個模型同時預測稻米病害和品種:輸出 20 個數字,前 10 個給病害、後 10 個給品種,各自算損失再相加。
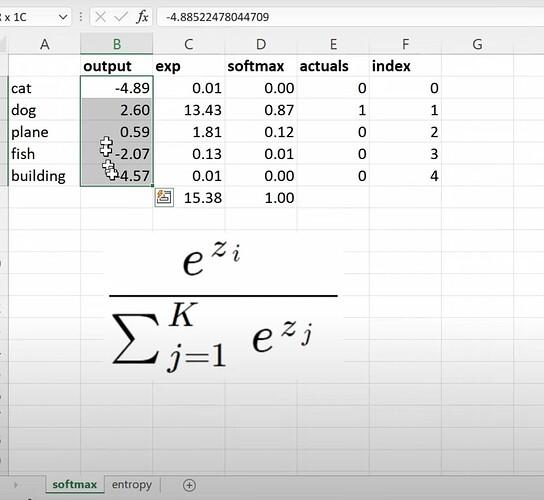
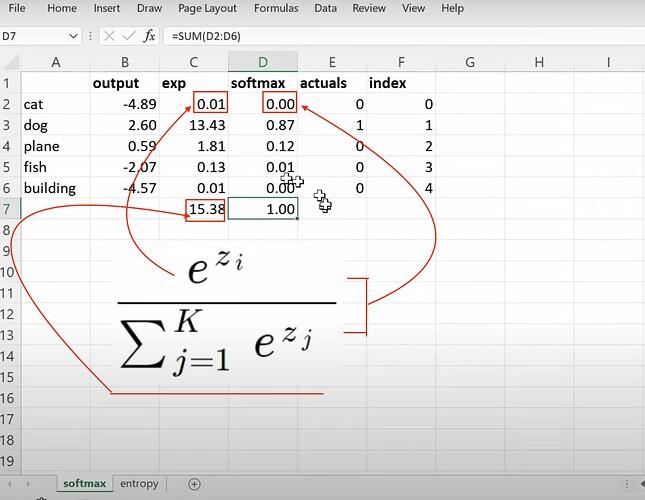
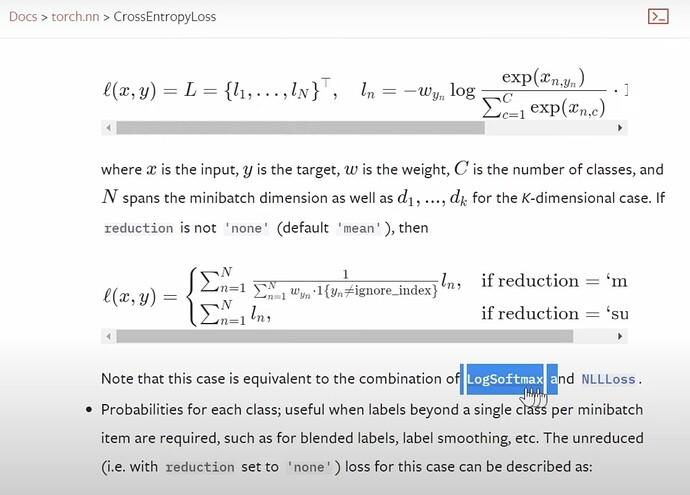
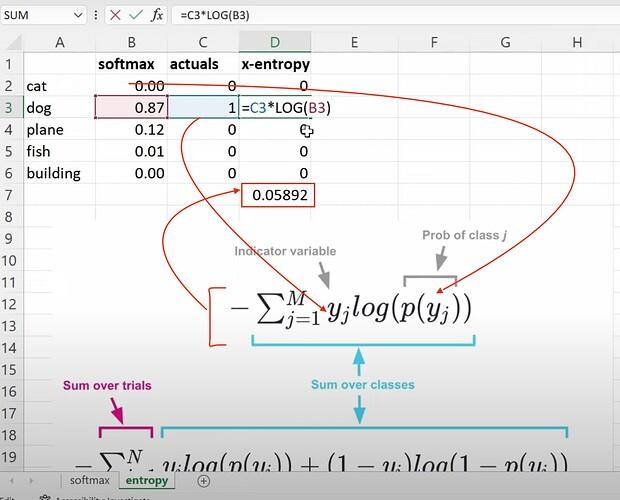
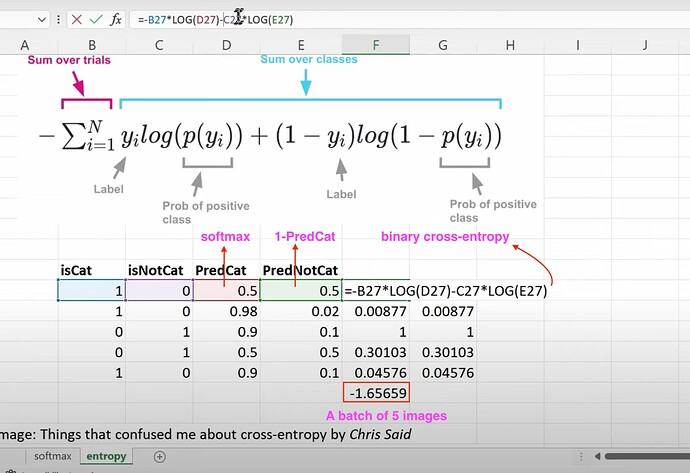
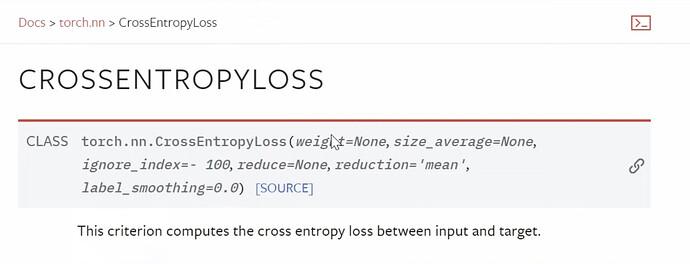
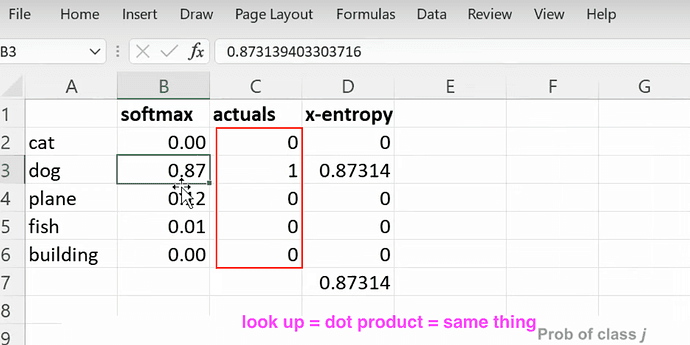
- Softmax 與交叉熵:softmax 把輸出變成加總為 1 的機率;交叉熵取正確類別機率的負對數當損失,越有信心答對損失越小。缺點:softmax 一定會選一個類別,給熊分類器看一隻貓,它也會硬選一種熊。
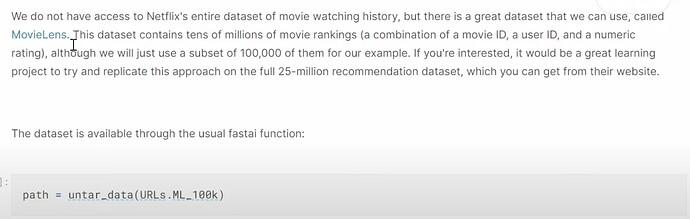
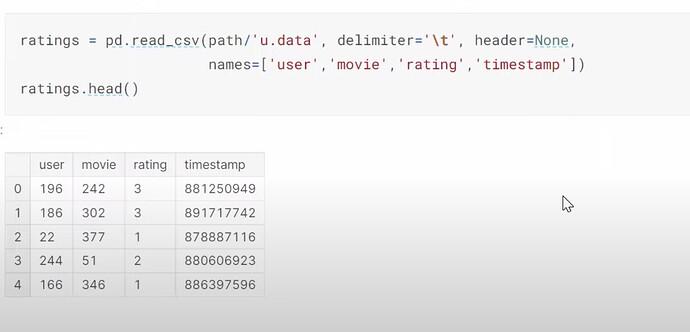
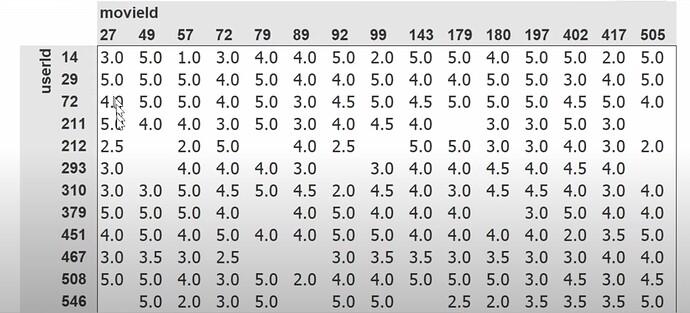
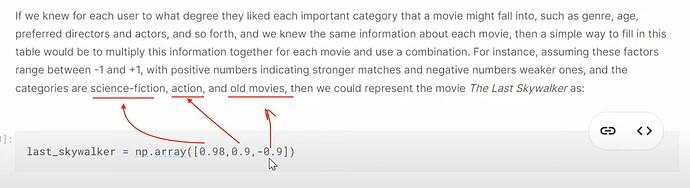
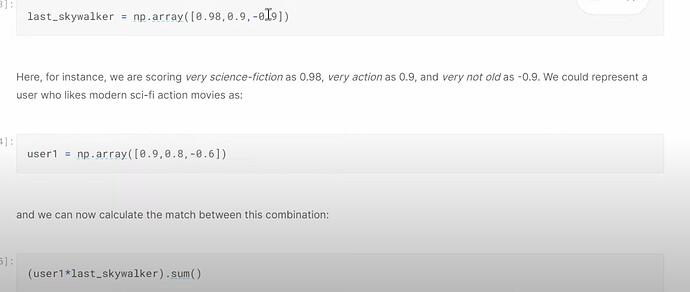
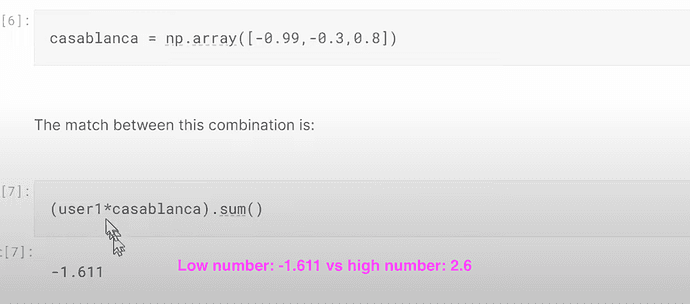
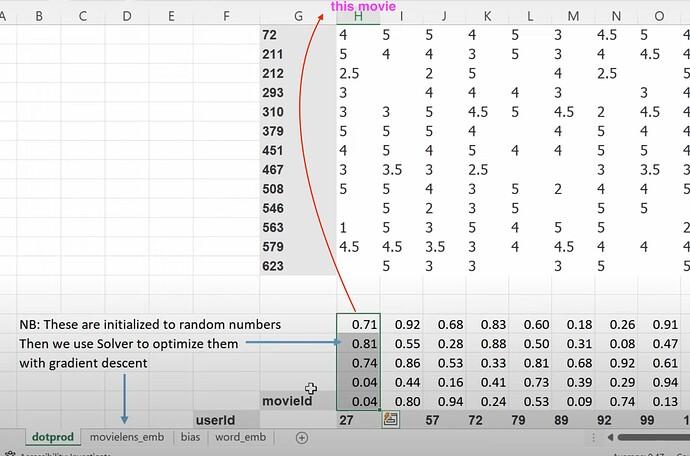
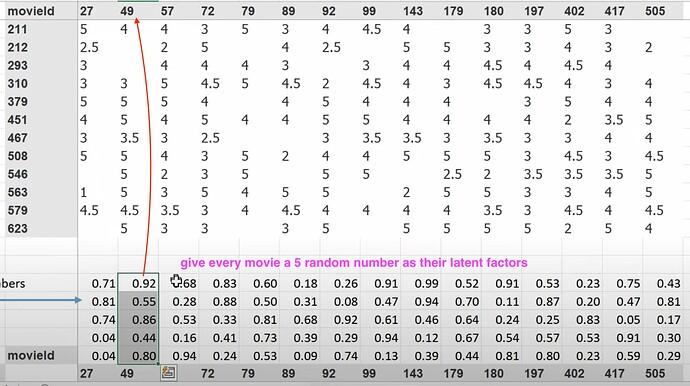
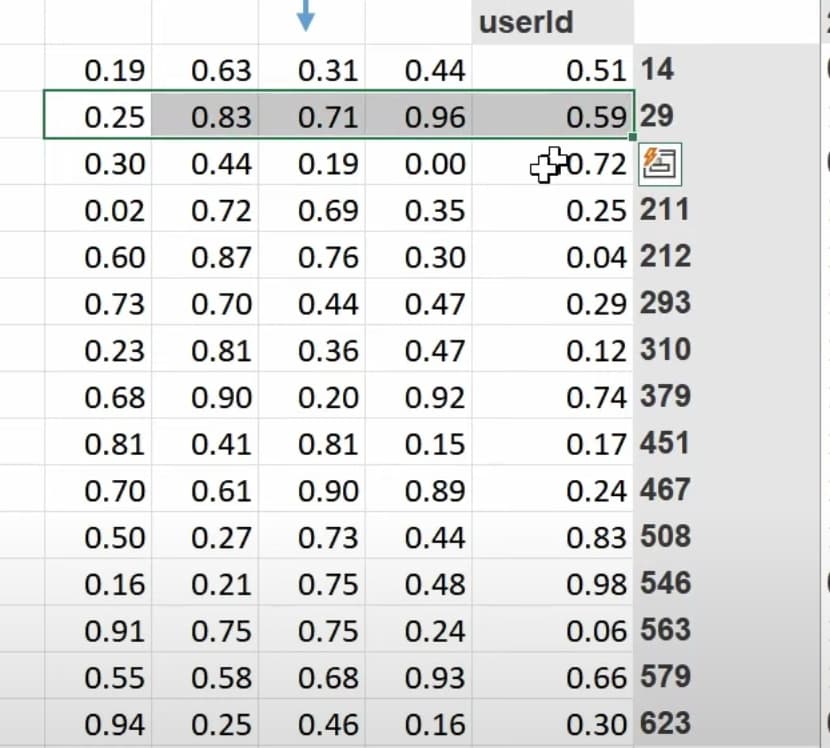
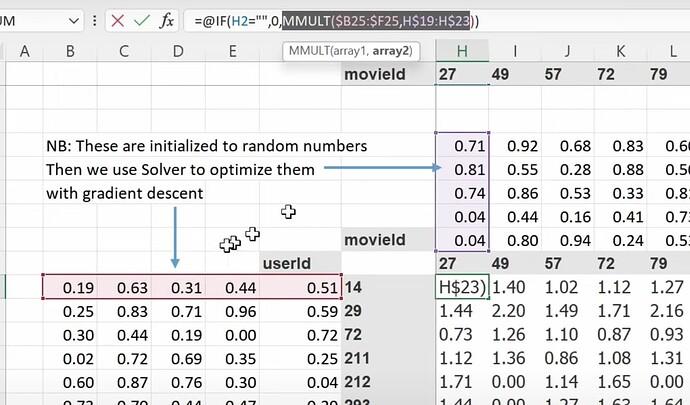
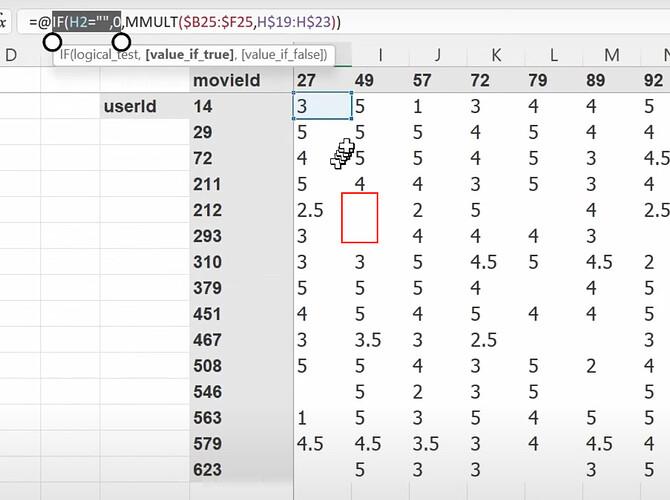
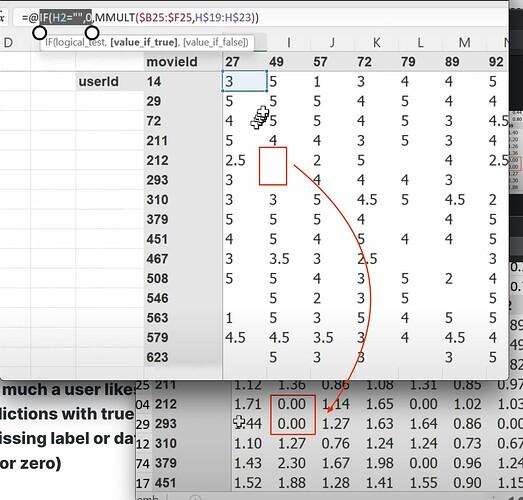
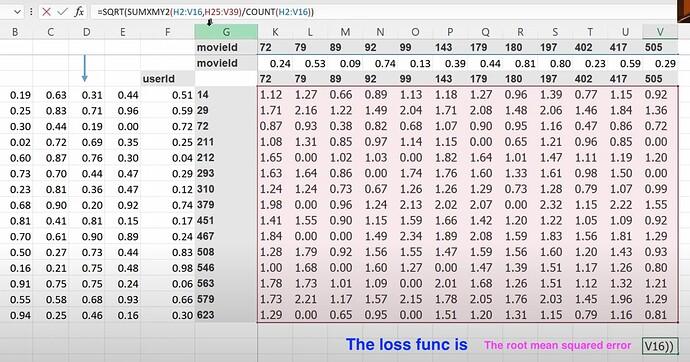
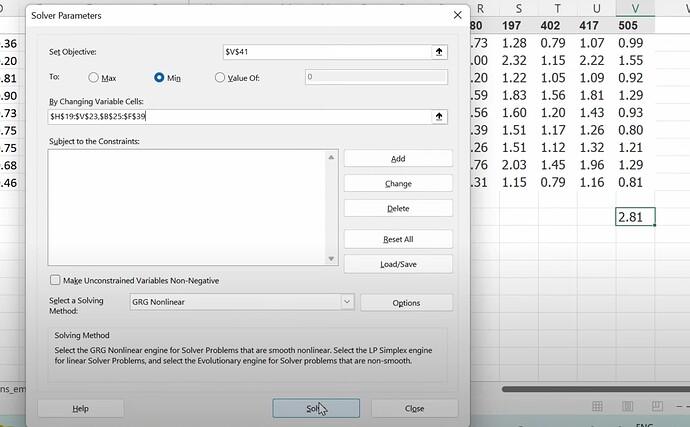
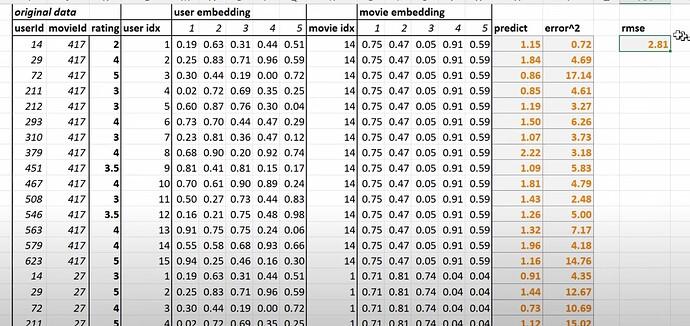
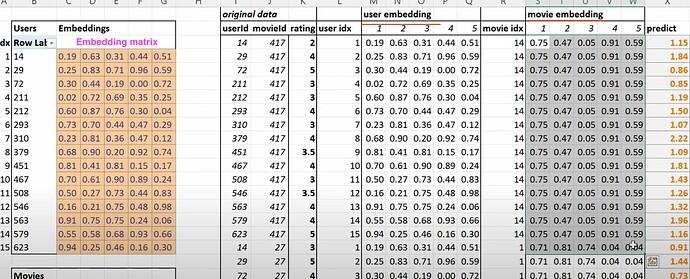
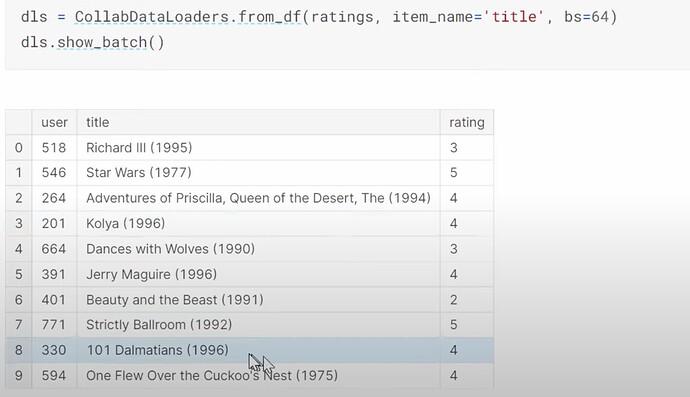
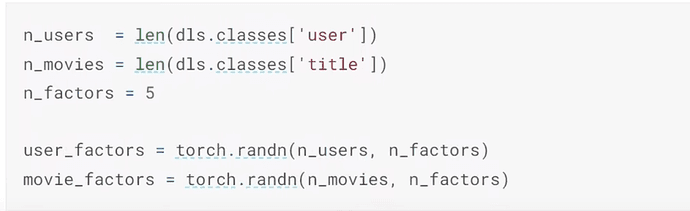
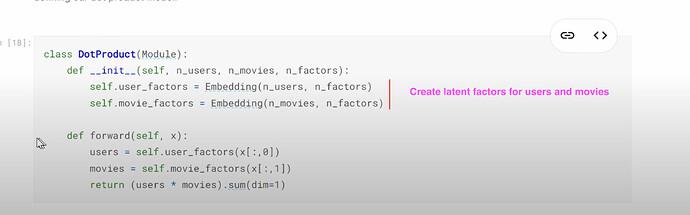
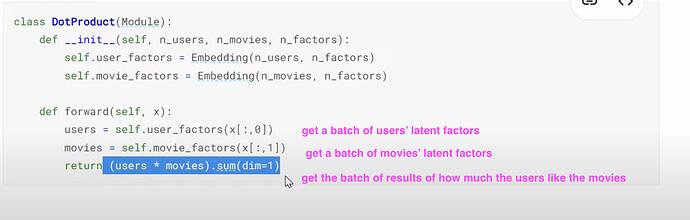
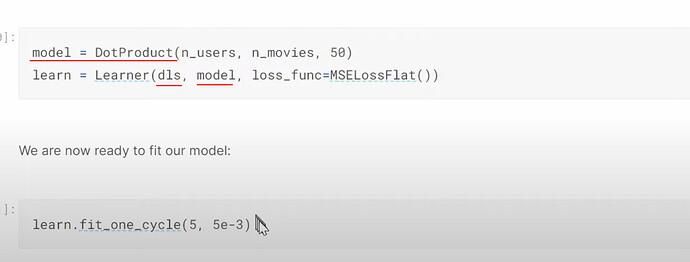
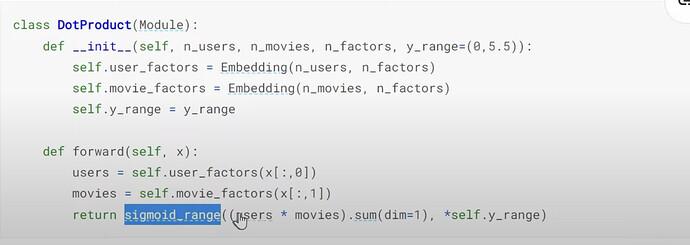
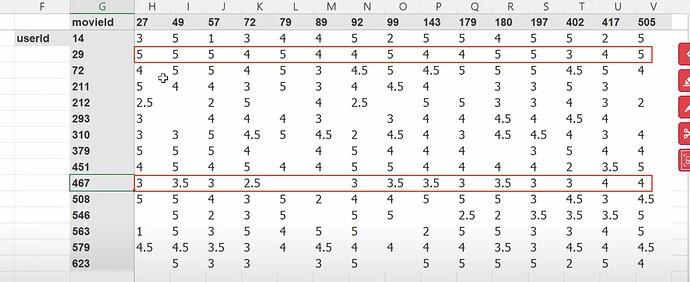
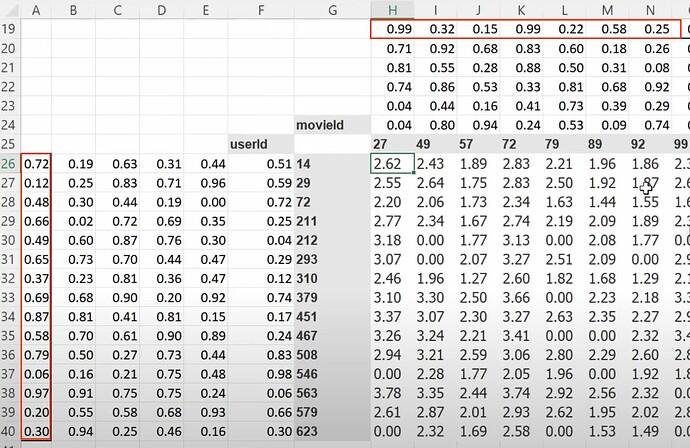
- 協同過濾:不知道電影類型也沒關係:替每個使用者和每部電影各隨機給一組「潛在因子」,兩者內積當預測評分,用 SGD 學出這些因子。喜好相似的人會得到相似的因子。
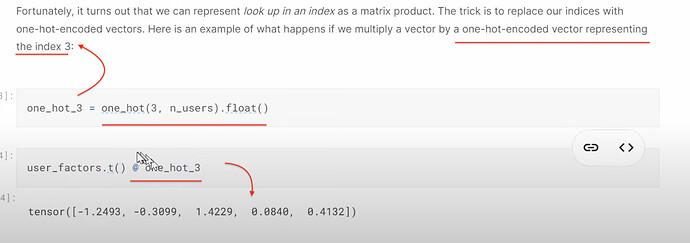
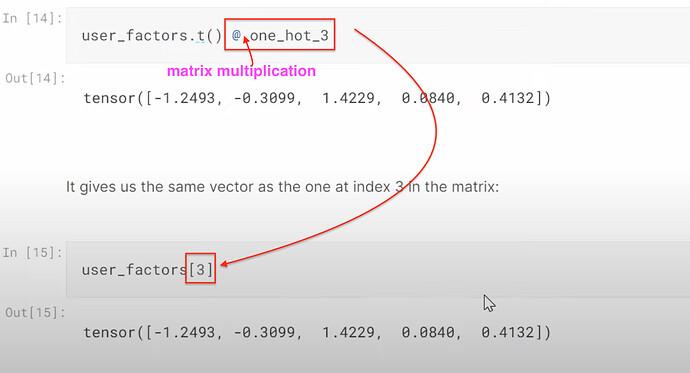
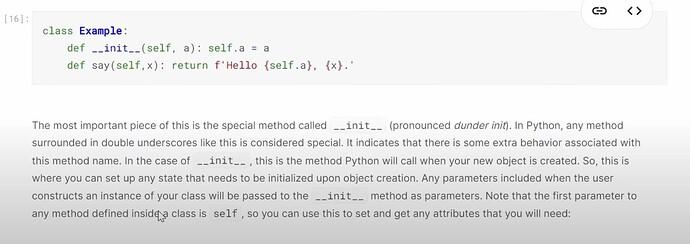
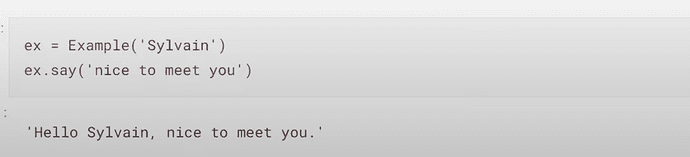
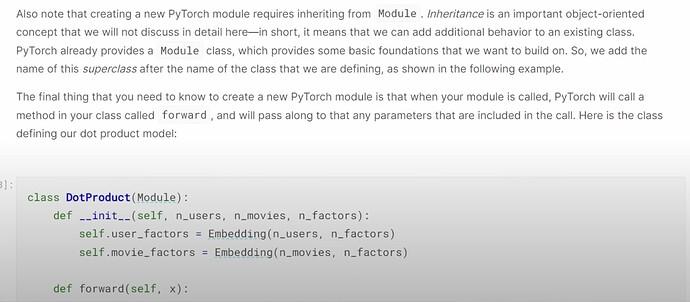
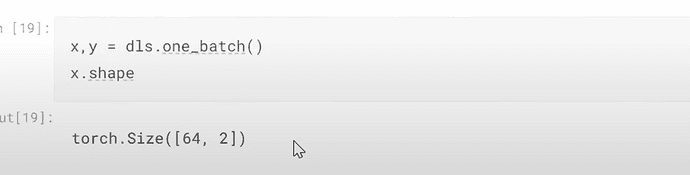
- 嵌入(Embedding):嵌入就是「用編號去查表」。在數學上等同於 one-hot 向量乘以矩陣,但查表快得多。用 PyTorch 的 Module 類別寫出 DotProduct 模型。
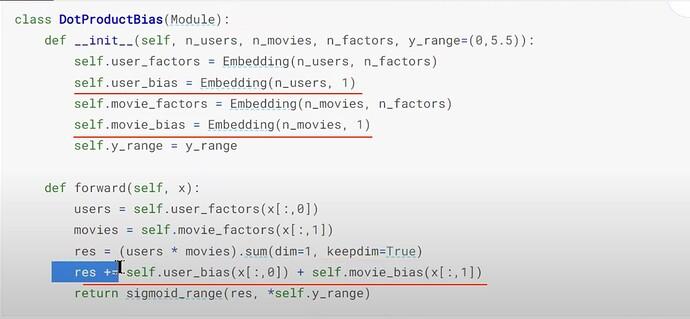
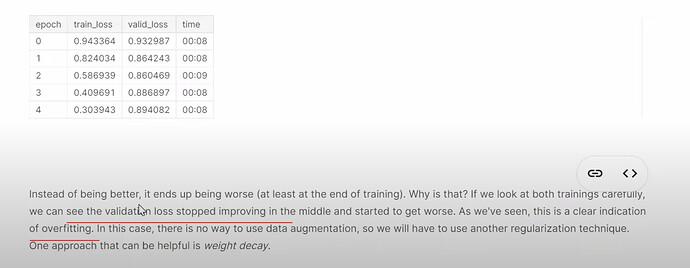
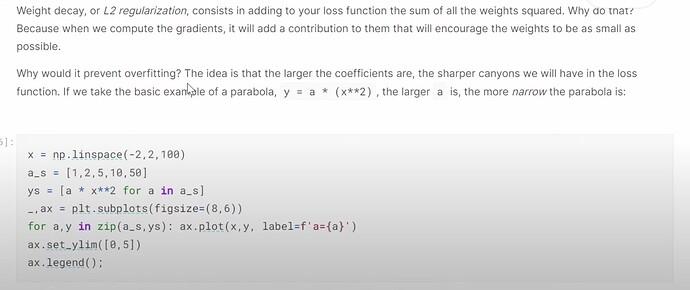
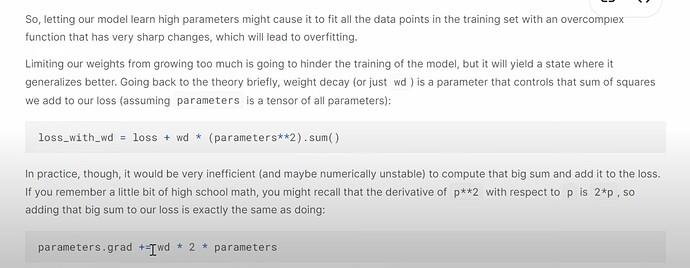
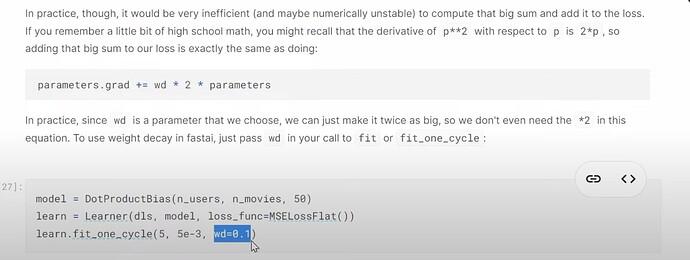
- 偏差與權重衰減:有些人什麼都給高分、有些電影人人都愛,所以加上使用者偏差和電影偏差。加了之後過擬合,用權重衰減(在損失加上權重平方和)把權重拉小,達到正則化。
關鍵概念
| 英文術語 | 中文 | 一句話解釋 |
|---|---|---|
| Collaborative filtering | 協同過濾 | 根據相似使用者的行為來推薦 |
| Latent factors | 潛在因子 | 模型自己學出來、描述喜好或特性的數字 |
| Embedding | 嵌入 | 用索引查表取得一組向量 |
| Dot product | 內積 | 兩組數字逐項相乘再加總 |
| Softmax | Softmax | 把一組數字轉成加總為 1 的機率 |
| Cross-entropy loss | 交叉熵損失 | −log(正確類別的機率) |
| Gradient accumulation | 梯度累積 | 多個小批次累積梯度後才更新一次 |
| Bias (in collab) | 偏差項 | 使用者或電影本身的整體高低傾向 |
| Weight decay | 權重衰減 | 在損失中加上權重平方和,防止權重過大 |
| Regularization | 正則化 | 減少過擬合的各種方法的統稱 |
認識關聯圖與重點圖

迷你範例:softmax 與交叉熵
| 原始輸出 | 2 | 1 | 0 |
|---|---|---|---|
| e^x | 7.389 | 2.718 | 1.000 |
| softmax | 0.665 | 0.245 | 0.090 |
正確答案是第 1 類時,交叉熵 = −ln(0.665) ≈ 0.408;正確答案是第 3 類時,交叉熵 = −ln(0.090) ≈ 2.408。
課堂截圖(取自官方 Summary 頁)

練習題
- 模型對三個類別輸出 [2, 1, 0]。算出 softmax(取三位小數),並確認加總是否為 1。
- 承上題,如果正確答案是第 1 類,交叉熵損失是多少?如果是第 3 類呢?哪個比較大?為什麼?
- 使用者因子 [0.9, 0.1, −0.5],電影因子 [0.8, −0.2, −0.6]。用內積算出預測分數。
- 為什麼要加使用者偏差和電影偏差?加了之後模型反而變差,原因是什麼?怎麼修?
- GPU 只放得下批次大小 32,但你想要批次 64 的效果。梯度累積怎麼做到?
- 中文學生作答:L07_中文F3學生_202611041526
- English student answers: L07_EN_F3_Student_202611041526
