IOAI 逐課重點
🏠 IOAI 總覽 | ← 大綱對照表 | 經典機器學習 →
這一頁怎麼用
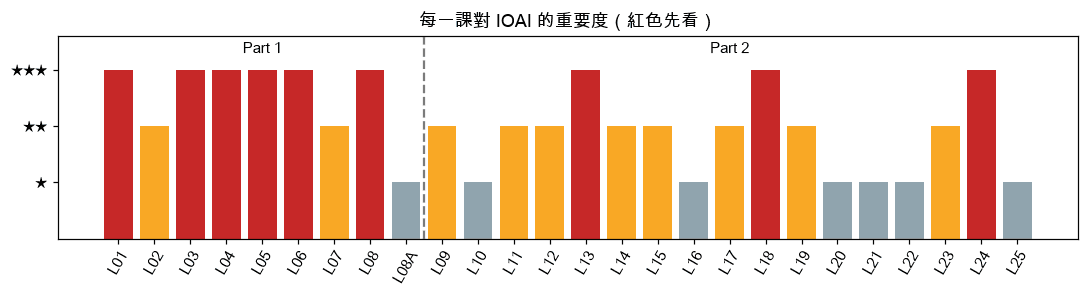
- 每課一張表,看完影片後對照勾選。⭐ 越多,對 IOAI 越重要。
- 看不懂的詞查 白話小辭典;數學看不懂查 中三數學補充
一眼看完
| 課 | 主題 | IOAI 重要度 | 對應大綱 |
|---|
| L01 | 影像分類、預訓練 | ⭐⭐⭐ | 影像分類、預訓練視覺模型、微調 |
| L02 | 部署、資料清理 | ⭐⭐ | 影像增強、混淆矩陣、過擬合 |
| L03 | 神經網路基礎 | ⭐⭐⭐ | 梯度下降、ReLU、MSE、線性迴歸 |
| L04 | NLP | ⭐⭐⭐ | 文字分類、斷詞、驗證集與測試集 |
| L05 | 從零打造模型 | ⭐⭐⭐ | PyTorch、特徵工程、sigmoid、MLP |
| L06 | 隨機森林 | ⭐⭐⭐ | 決策樹、Bagging、Boosting、特徵重要性 |
| L07 | 協同過濾 | ⭐⭐ | 嵌入、L2(weight decay)、交叉熵 |
| L08 | CNN | ⭐⭐⭐ | 卷積、池化、Dropout |
| L08A | 資料倫理 | ⭐ | 大綱沒列,但是常識 |
| L09 | Stable Diffusion | ⭐⭐ | CLIP、自編碼器、擴散模型 |
| L10 | 管線拆解 | ⭐ | 擴散模型 |
| L11 | 矩陣乘法 | ⭐⭐ | 張量操作、廣播 |
| L12 | 均值漂移分群 | ⭐⭐ | 分群(接近 K-Means)、GPU |
| L13 | 反向傳播與 MLP | ⭐⭐⭐ | 反向傳播、MLP、連鎖律 |
| L14 | 重構反向傳播 | ⭐⭐ | PyTorch nn.Module、DataLoader |
| L15 | 自編碼器 | ⭐⭐ | 自編碼器、卷積 |
| L16 | Learner 框架 | ⭐ | 學習率搜尋 |
| L17 | 初始化與正規化 | ⭐⭐ | 權重初始化、BatchNorm |
| L18 | 加速 SGD、ResNet | ⭐⭐⭐ | Momentum、Adam、學習率排程、ResNet |
| L19 | DDPM、Dropout | ⭐⭐ | Dropout、擴散模型 |
| L20 | 混合精度 | ⭐ | GPU 訓練 |
| L21 | DDIM | ⭐ | 擴散模型 |
| L22 | Karras 論文 | ⭐ | 擴散模型 |
| L23 | 超解析度 | ⭐⭐ | U-Net(影像分割的骨架) |
| L24 | 注意力與 Transformer | ⭐⭐⭐ | 注意力、Transformer |
| L25 | 潛在擴散 | ⭐ | 自編碼器(VAE)、擴散模型 |
Part 1
L01|開始上手 ⭐⭐⭐
| 項目 | 內容 |
|---|
| 大綱項目 | Image Classification、Pre-trained Vision Encoders、Model Finetuning |
| 必懂觀念 | 圖片就是數字;預訓練模型已經學會看邊緣與形狀,只要微調最後幾層 |
| 必會程式 | vision_learner(dls, resnet18, metrics=error_rate)、learn.fine_tune(3) |
| 比賽怎麼考 | 給一個小影像資料集,在時限內做出最高準確率。先用預訓練模型微調幾乎永遠是第一步 |
| 本庫 | L01_開始上手_202611041526、L01 中文導讀 |
L02|部署 ⭐⭐
| 項目 | 內容 |
|---|
| 大綱項目 | Image Augmentation、Confusion Matrix、Underfitting/Overfitting |
| 必懂觀念 | 先訓練再清資料:用模型找出最錯的圖片;資料增強讓模型看到更多變化 |
| 必會程式 | aug_transforms()、RandomResizedCrop、ClassificationInterpretation.plot_confusion_matrix() |
| 比賽怎麼考 | 看混淆矩陣說出「哪兩類最容易搞混」;選擇合適的增強(醫學影像不能隨便翻轉) |
| 本庫 | L02_模型部署_202611041526 |
L03|神經網路基礎 ⭐⭐⭐
| 項目 | 內容 |
|---|
| 大綱項目 | Gradient Descent、Activation(ReLU)、Loss(MSE)、Linear Regression、Perceptron |
| 必懂觀念 | 很多個 ReLU 加起來可以畫出任何形狀;梯度=斜率,往斜率反方向走一小步 |
| 必會程式 | loss.backward()、params -= lr * params.grad、params.grad.zero_() |
| 比賽怎麼考 | 手算一步梯度下降;判斷學習率太大或太小(見 圖解速查 圖 3) |
| 本庫 | L03_神經網路基礎_202611041526、Python 必備知識 主題 13 |
L04|自然語言處理 ⭐⭐⭐
| 項目 | 內容 |
|---|
| 大綱項目 | Text Classification、Tokenization、Pre-trained Text Encoders、Train/Val/Test split |
| 必懂觀念 | 文字 → token → 數字;驗證集選模型、測試集只看一次;過擬合的意思 |
| 必會程式 | AutoTokenizer.from_pretrained(...)、Trainer(...)、train_test_split |
| 比賽怎麼考 | 用 Hugging Face 預訓練模型做文字分類;正確切資料(時間序列要按時間切) |
| 本庫 | L04_自然語言處理_202611041526 |
L05|從零打造模型 ⭐⭐⭐
| 項目 | 內容 |
|---|
| 大綱項目 | PyTorch Basics、Pandas、Feature Engineering、Data Processing、Logistic(sigmoid)、MLP |
| 必懂觀念 | 缺失值補眾數;類別欄位做 one-hot;數值欄位取 log 或標準化;sigmoid 把輸出壓到 0 到 1 |
| 必會程式 | df.fillna(modes)、pd.get_dummies、torch.sigmoid、矩陣乘法 @ |
| 比賽怎麼考 | 表格資料題:清理 → 特徵 → 模型,三步都要會 |
| 本庫 | L05_從零打造模型_202611041526、Python 筆記主題 12 |
L06|隨機森林 ⭐⭐⭐
| 項目 | 內容 |
|---|
| 大綱項目 | Decision Trees、Bagging、Random Forest、Gradient Boosting、Feature Importance |
| 必懂觀念 | 一棵樹會過擬合;很多棵樹各看部分資料再平均(bagging)就穩了;boosting 是一棵接一棵修正錯誤 |
| 必會程式 | RandomForestClassifier(n_estimators=100)、.feature_importances_ |
| 比賽怎麼考 | 表格資料先跑隨機森林當基準線;用特徵重要性解釋模型 |
| 本庫 | L06_隨機森林_202611041526、經典機器學習補缺 §3 |
L07|協同過濾 ⭐⭐
| 項目 | 內容 |
|---|
| 大綱項目 | Embeddings、L2 Regularization(weight decay)、Cross Entropy |
| 必懂觀念 | 嵌入=查表得到一排數字;weight decay=在損失加上權重平方和,讓權重不要太大 |
| 必會程式 | nn.Embedding(n, k)、wd=0.1、F.cross_entropy |
| 比賽怎麼考 | 把類別或 ID 變成嵌入;解釋 L2 為什麼能減少過擬合 |
| 本庫 | L07_協同過濾_202611041526 |
L08|卷積神經網路 ⭐⭐⭐
| 項目 | 內容 |
|---|
| 大綱項目 | Convolutional Layers、Pooling(Max、Average)、Dropout |
| 必懂觀念 | 卷積核在圖上滑動算乘積和;stride 2 讓圖變一半;池化取最大或平均 |
| 必會程式 | nn.Conv2d(1, 8, kernel_size=3, stride=2, padding=1)、nn.MaxPool2d(2)、nn.Dropout(0.5) |
| 比賽怎麼考 | 算輸出尺寸:(輸入 + 2×padding − kernel) ÷ stride + 1(見 圖解速查 圖 6) |
| 本庫 | L08_卷積神經網路_202611041526 |
L08A|資料倫理 ⭐
Part 2
| 課 | 大綱項目 | 必懂一句話 | 必會程式 | 重要度 |
|---|
| L09 | CLIP、Autoencoder、Diffusion | 文字和圖片被 CLIP 放進同一個空間;擴散=一步步去雜訊 | StableDiffusionPipeline | ⭐⭐ |
| L10 | Diffusion | 管線=文字編碼器 + U-Net + VAE 解碼器 | 手動跑去雜訊迴圈 | ⭐ |
| L11 | Tensor Manipulation | 廣播規則:從最後一維對齊,1 可以擴展 | a[:, None] * b[None, :] | ⭐⭐ |
| L12 | Clustering、GPU | 均值漂移:每個點往附近點的平均移動 | 批次化在 GPU 上算距離 | ⭐⭐ |
| L13 | Backpropagation、MLP | 連鎖律:外層導數 × 內層導數 | 手寫 lin_grad | ⭐⭐⭐ |
| L14 | PyTorch Basics | nn.Module、Dataset、DataLoader 自己寫一次 | class Model(nn.Module) | ⭐⭐ |
| L15 | Autoencoders、Conv | 壓縮再還原,中間的小向量就是特徵 | nn.ConvTranspose2d | ⭐⭐ |
| L16 | Learning Rates | 學習率搜尋:從小到大試,選損失下降最快處 | lr_find() | ⭐ |
| L17 | Initialization、BatchNorm | 初始化太大會爆、太小會消失;BatchNorm 讓每層輸入平均 0、標準差 1 | nn.init.kaiming_normal_、nn.BatchNorm2d | ⭐⭐ |
| L18 | Momentum、Adam、ResNet | Adam=動量 + 自適應學習率;ResNet 用捷徑讓深網路好訓練 | torch.optim.AdamW、OneCycleLR | ⭐⭐⭐ |
| L19 | Dropout、Diffusion | Dropout 訓練時隨機關掉神經元,測試時全開 | model.train() vs model.eval() | ⭐⭐ |
| L20 | GPU 訓練 | 混合精度=用 16 位元算,快一倍、省記憶體 | torch.autocast | ⭐ |
| L21 | Diffusion | DDIM 用更少步數生成 | | ⭐ |
| L22 | Diffusion | Karras 的雜訊排程 | | ⭐ |
| L23 | Segmentation(U-Net) | U-Net:先縮小再放大,中間用跳接把細節傳過去 | U-Net 結構 | ⭐⭐ |
| L24 | Attention、Transformers | 注意力=用 Q、K 算相似度,softmax 後加權 V | softmax(Q @ K.T / sqrt(d)) @ V | ⭐⭐⭐ |
| L25 | Autoencoders(VAE)、Diffusion | 在 VAE 的小空間裡做擴散,比較省力 | | ⭐ |
看課建議(備賽版)
| 階段 | 看什麼 | 為什麼 |
|---|
| 1 | L01–L08 全部 | 涵蓋大綱一半,實作能力的核心 |
| 2 | 經典機器學習補缺 | 大綱第 1 部分的缺口最多 |
| 3 | L13、L14、L17、L18、L24 | ⭐⭐⭐ 和 ⭐⭐ 的理論課,對應「兩者」類題目 |
| 4 | 視覺語言音訊補缺 | 物件偵測、GAN、Whisper |
| 5 | 其餘 Part 2 | 有時間再看,擴散模型只考實作 |
🏠 IOAI 總覽 | ← 大綱對照表 | 經典機器學習 →
