L08|卷積神經網路(CNN)與嵌入解讀
先完成協同過濾:從零寫嵌入、解讀電影偏差與 PCA 圖;再打開 CNN,理解卷積、池化、stride 與 dropout。
L08|卷積神經網路(CNN)與嵌入解讀(Convolutions (CNNs))
零基礎提示
- 這一課不用額外數學
- 看不懂的詞查 白話小辭典
- 字幕:離線網站選「中英」(電腦翻譯,大意正確)
先完成協同過濾:從零寫嵌入、解讀電影偏差與 PCA 圖;再打開 CNN,理解卷積、池化、stride 與 dropout。 (Finish collaborative filtering (embeddings from scratch, movie biases, PCA), then open up CNNs: convolutions, pooling, stride and dropout.)
| 項目 | 內容 |
|---|---|
| 所屬 | Part 1:Practical Deep Learning |
| 影片 | YouTube |
| 對應書本章節 | 第 13 章 Convolutions |
| 原始頁面 | Lessons/lesson8 |
| 難度(F3 視角) | ★★★★☆ 進階 |
影片
本課重點
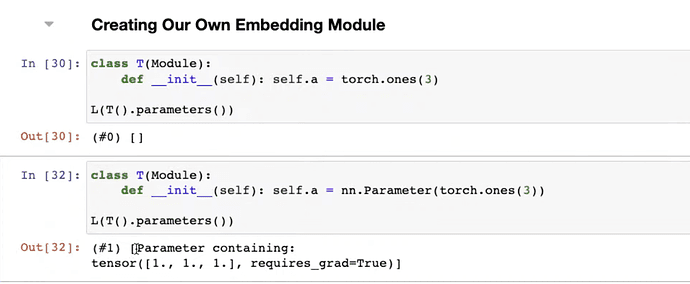
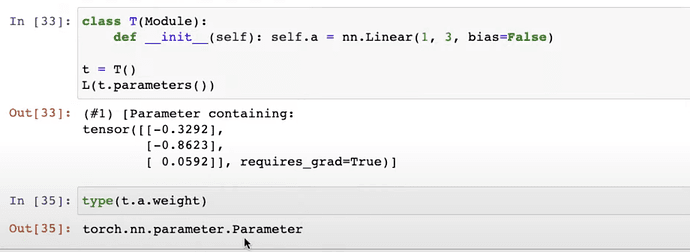
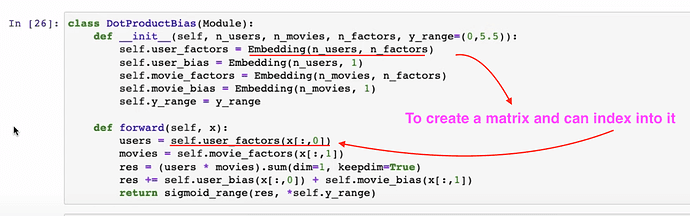
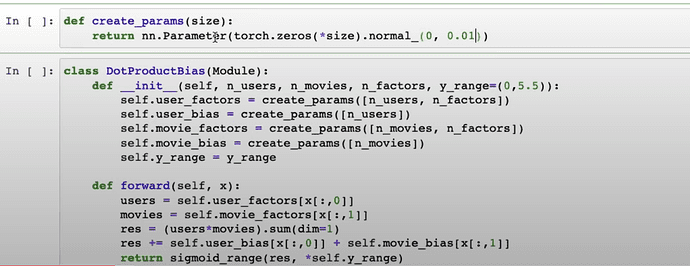
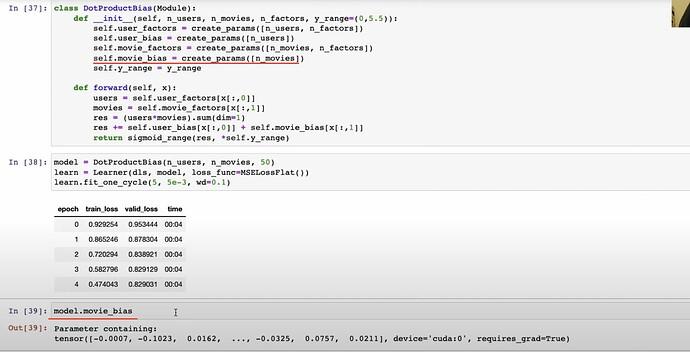
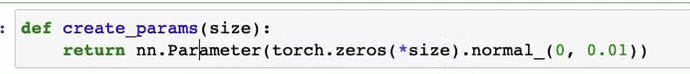
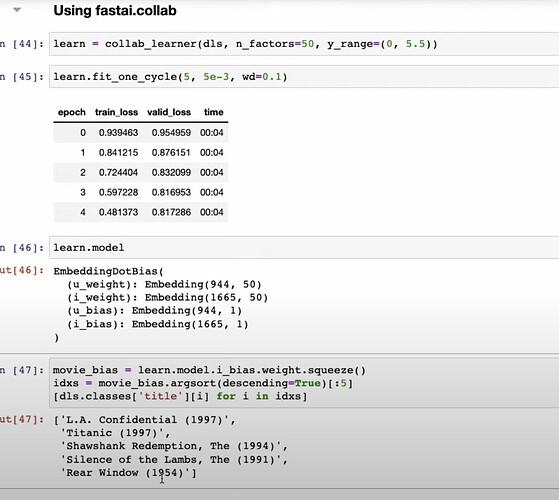
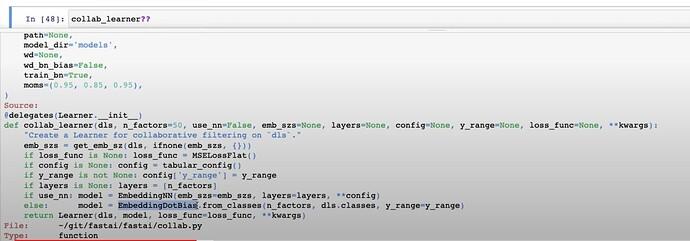
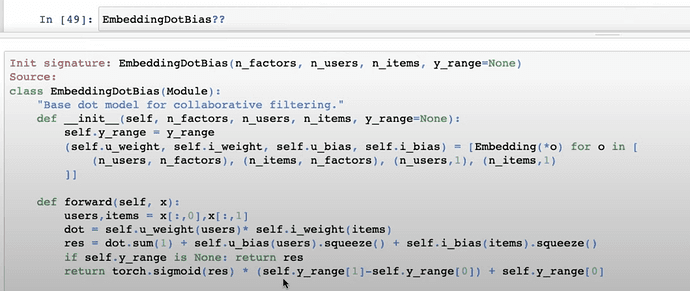
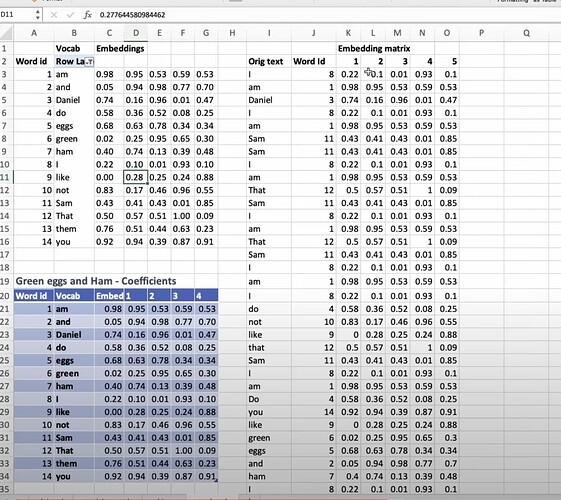
- 從零寫嵌入:用 nn.Parameter 和 normal_ 建立隨機矩陣,寫出自己的 Embedding 與 DotProductBias 模型。nn.Module 會自動追蹤所有參數。
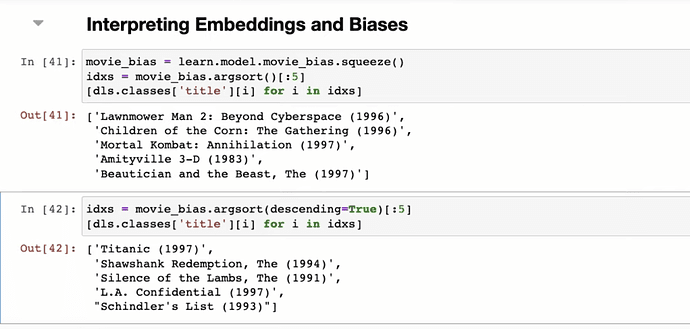
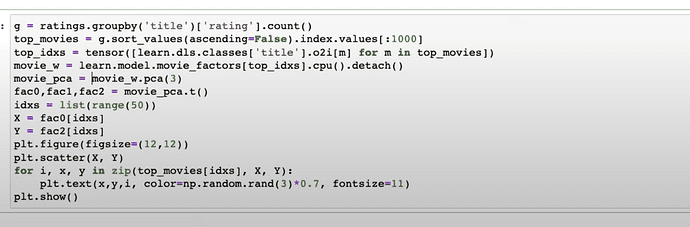
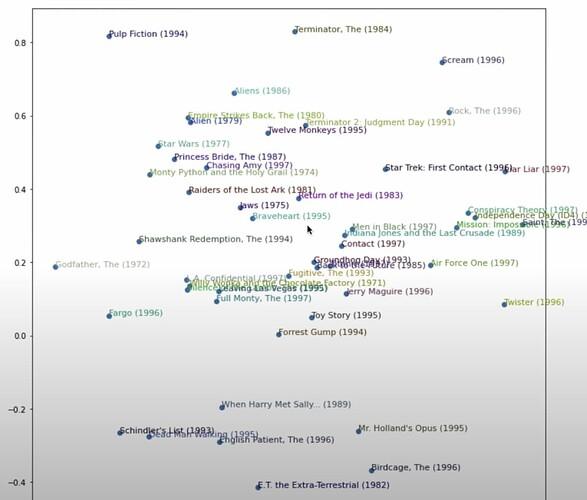
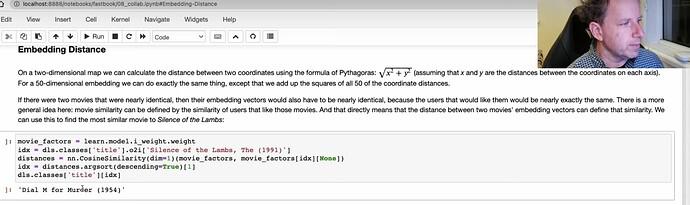
- 解讀嵌入:電影偏差低代表「就算是喜歡這類電影的人也不愛它」,偏差高代表大家都愛。用 PCA 把 50 個潛在因子壓成 2 到 3 個來畫圖,可以看到電影依口味分群;用嵌入距離可以找相似電影。
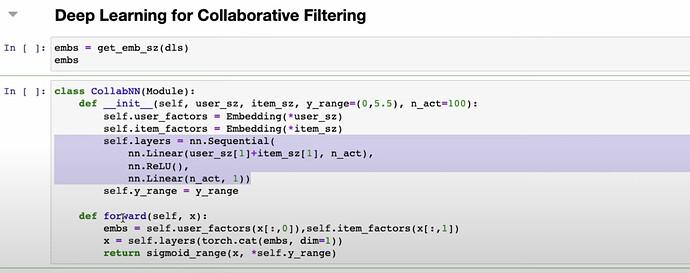
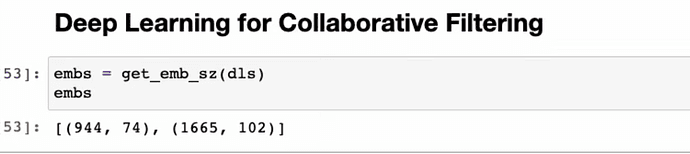
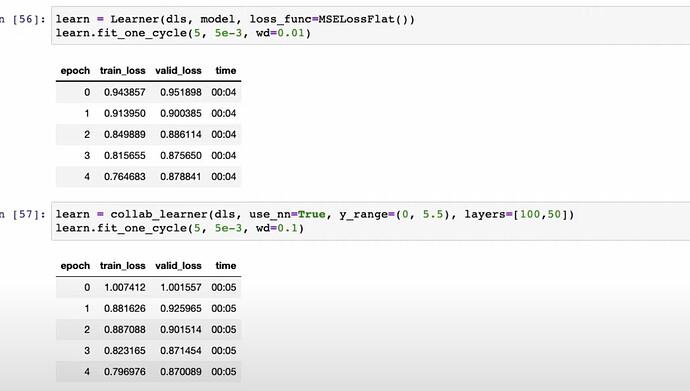
- 用深度學習做協同過濾:把使用者和電影嵌入接起來送進神經網路,也能做推薦,還能加入其他欄位。fastai 用經驗法則決定嵌入大小。嵌入也能用在表格模型的類別欄位上。
- 卷積:卷積核(filter)是一個小方格(如 3×3),在圖片上滑動,每個位置做「對應格相乘再加總」。不同的核偵測水平邊、垂直邊等特徵;第二層再組合第一層的特徵。這些核也是用 SGD 學出來的。
- 池化與 stride:Max pooling 每 2×2 取最大值,把圖縮小一半;現代做法改用 stride 2 卷積(每次跳兩格)縮小圖片,最後用平均池化得到每個通道一個數字。
- Dropout:訓練時隨機把一部分激活值設為 0,強迫模型不依賴少數特徵,減少過擬合;剩下的值要放大以保持平均不變。預測時不使用 dropout。
- Part 1 之後:Jeremy 的建議:寫部落格、在論壇幫助別人、組讀書會;專注在不太會變的基礎;推薦閱讀 Radek 的《Meta Learning》。
關鍵概念
| 英文術語 | 中文 | 一句話解釋 |
|---|---|---|
| Convolution | 卷積 | 小方格在圖上滑動,逐格相乘加總 |
| Kernel / Filter | 卷積核 | 卷積用的小方格權重,用來偵測特定圖案 |
| Channel | 通道 | 每個卷積核輸出一張特徵圖,叫一個通道 |
| Max pooling | 最大池化 | 每個小區塊只保留最大值,縮小圖片 |
| Stride | 步幅 | 卷積核每次移動的格數 |
| Dropout | 隨機失活 | 訓練時隨機把部分激活值設為 0 |
| PCA | 主成分分析 | 把很多維的資料壓成少數幾維來觀察 |
| nn.Module | PyTorch 模組 | 所有 PyTorch 模型的基礎類別,會追蹤參數 |
| Activation | 激活值 | 每一層計算出來的中間結果 |
認識關聯圖與重點圖

迷你範例:卷積與最大池化
水平邊偵測核 [[-1,-1,-1],[0,0,0],[1,1,1]] 作用在上半黑(0)、下半白(9)的 4×4 圖片,每個位置輸出 27,代表偵測到明顯的水平邊。
| 4×4 輸入 | 2×2 最大池化輸出 |
|---|---|
[[1,3,2,0],[5,4,1,1],[0,2,8,6],[1,1,3,7]] | [[5,2],[2,8]] |
課堂截圖(取自官方 Summary 頁)
練習題
- 4×4 圖片上兩列全是 0、下兩列全是 9。用卷積核
[[−1,−1,−1],[0,0,0],[1,1,1]](不補邊)做卷積,輸出是幾乘幾?每格的值是多少?這個核在偵測什麼? - 對矩陣
[[1,3,2,0],[5,4,1,1],[0,2,8,6],[1,1,3,7]]做 2×2 最大池化,寫出結果。 - Dropout 的機率是 0.5 時,訓練中沒被設為 0 的值要乘以多少?為什麼?預測時要不要用 dropout?
- 一部電影的偏差(bias)很低,代表什麼?為什麼這比單看平均評分更有意義?
- 用自己的話說明:為什麼 CNN 第二層可以偵測比第一層更複雜的圖案?
- 中文學生作答:L08_中文F3學生_202611041526
- English student answers: L08_EN_F3_Student_202611041526
