IOAI 補缺|經典機器學習(fast.ai 沒教的部分)
scikit-learn、邏輯斯迴歸、L1/L2、K-NN、SVM、分群、降維、評估指標、交叉驗證、特徵工程。每一節:一張表、一張圖、一段可以照抄執行的程式。
IOAI 補缺|經典機器學習
這一頁怎麼用
scikit-learn 只要記一個套路
| 步驟 | 程式 | 意思 |
|---|---|---|
| 1 建模型 | m = 模型名稱(參數) | 選工具 |
| 2 訓練 | m.fit(X_train, y_train) | 學 |
| 3 預測 | m.predict(X_test) | 用 |
| 4 打分 | m.score(X_test, y_test) | 看準不準 |
所有模型都是這四步,換模型只要改第 1 行。
跟著做
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier

X, y = load_iris(return_X_y=True)                 # 150 朵花、4 個特徵、3 種
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)
m = DecisionTreeClassifier(random_state=0)        # 1 建模型
m.fit(X_train, y_train)                           # 2 訓練
print(m.predict(X_test[:5]))                      # 3 預測 → [2 1 0 2 0]
print(round(m.score(X_test, y_test), 3))          # 4 打分 → 0.978
§0|畫圖:Matplotlib 與 Seaborn
| 想看什麼 | Matplotlib | Seaborn |
|---|---|---|
| 一個數字欄位的分布 | plt.hist(x) | sns.histplot(df, x='欄') |
| 兩個欄位的關係 | plt.scatter(x, y) | sns.scatterplot(df, x=, y=, hue=) |
| 隨時間變化(損失曲線) | plt.plot(x, y) | sns.lineplot(...) |
| 各類別平均 | plt.bar(names, values) | sns.barplot(df, x=, y=) |
| 欄位之間的相關 | plt.imshow(df.corr()) | sns.heatmap(df.corr(), annot=True) |
跟著做
import seaborn as sns
import matplotlib.pyplot as plt

df = sns.load_dataset('penguins').dropna()        # 企鵝資料(Kaggle、Colab 可直接載入)
fig, axs = plt.subplots(1, 2, figsize=(10, 4))
sns.scatterplot(df, x='flipper_length_mm', y='body_mass_g', hue='species', ax=axs[0])
sns.heatmap(df.select_dtypes('number').corr(), annot=True, fmt='.2f', ax=axs[1])
plt.tight_layout(); plt.show()
比賽提示
拿到資料第一件事是畫圖,看分布、看缺值、看類別是否平衡。
§1|邏輯斯迴歸(Logistic Regression)
| 項目 | 內容 |
|---|---|
| 做什麼 | 分類(名字有迴歸,其實是分類) |
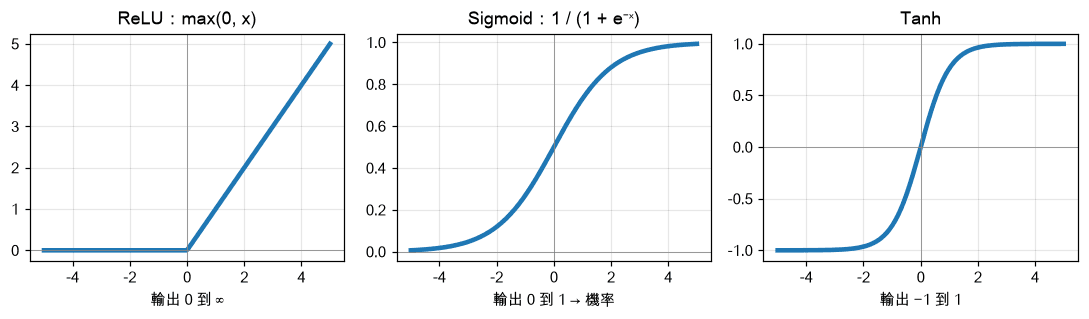
| 怎麼做 | 線性組合 z = w·x + b,再用 sigmoid 壓成 0 到 1 的機率 |
| 損失 | 二元交叉熵 |
| 優點 | 快、可解釋(看權重 w 就知道哪個特徵重要) |
| 缺點 | 邊界只能是直線(見下圖第 1 格) |
| 和 fast.ai | L05 的 Titanic 線性模型加 sigmoid,就是邏輯斯迴歸 |
跟著做
from sklearn.datasets import load_breast_cancer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X, y = load_breast_cancer(return_X_y=True)        # 569 個腫瘤、30 個特徵、良性/惡性
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)
m = make_pipeline(StandardScaler(), LogisticRegression())   # 先標準化再訓練
m.fit(X_train, y_train)
print(round(m.score(X_test, y_test), 3))          # → 0.977
print(m.predict_proba(X_test[:2]).round(3))       # 每列是 [P(0), P(1)] → [[0.999 0.001] [0.04 0.96]]
§2|正則化:L1、L2、Dropout、Early Stopping
| 方法 | 做法 | 效果 | 在哪裡用 |
|---|---|---|---|
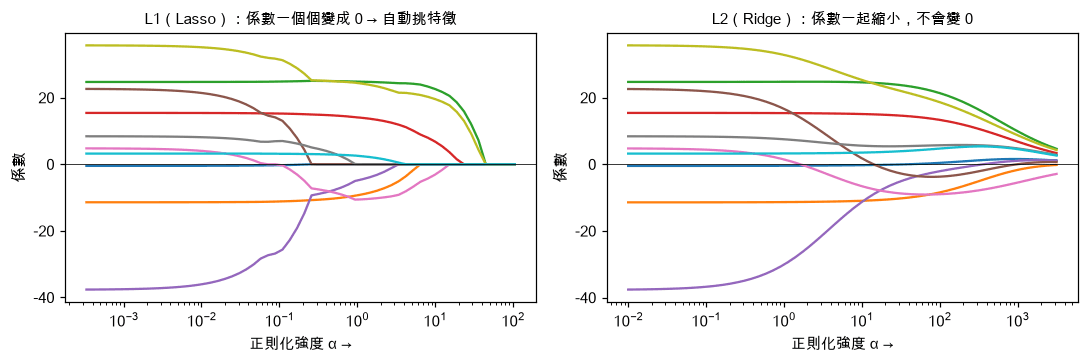
| L1(Lasso) | 損失 + α × Σ|w| | 很多權重變成 0 → 自動挑特徵 | Lasso(alpha=)、LogisticRegression(penalty='l1', solver='liblinear') |
| L2(Ridge) | 損失 + α × Σw² | 權重一起縮小,不會變 0 | Ridge(alpha=);神經網路的 weight_decay |
| Dropout | 訓練時隨機關掉一部分神經元 | 不能依賴某幾個神經元 | nn.Dropout(0.5)(fast.ai L08、L19) |
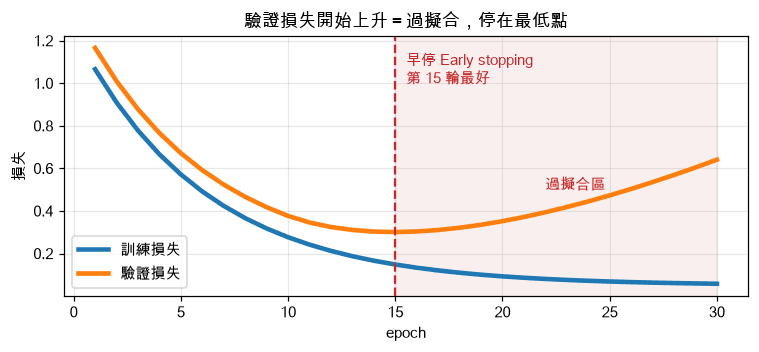
| Early Stopping | 驗證損失不再下降就停 | 停在過擬合之前 | 每輪記錄驗證損失,留最好的那一版 |
跟著做
from sklearn.datasets import load_diabetes
from sklearn.linear_model import Lasso, Ridge
from sklearn.preprocessing import StandardScaler

X, y = load_diabetes(return_X_y=True)             # 10 個特徵預測糖尿病進展
X = StandardScaler().fit_transform(X)
for M in [Lasso(alpha=5), Ridge(alpha=5)]:
    w = M.fit(X, y).coef_
    print(type(M).__name__, '變成 0 的權重數:', (abs(w) < 1e-6).sum())
# → Lasso 變成 0 的權重數: 5
# → Ridge 變成 0 的權重數: 0
比賽提示
特徵很多、懷疑很多沒用 → 用 L1。只是想防過擬合 → 用 L2。α 越大,懲罰越重。
§3|K-NN、SVM 與樹模型比較
| 模型 | 一句話 | 邊界形狀 | 要標準化嗎 | 關鍵參數 |
|---|---|---|---|---|
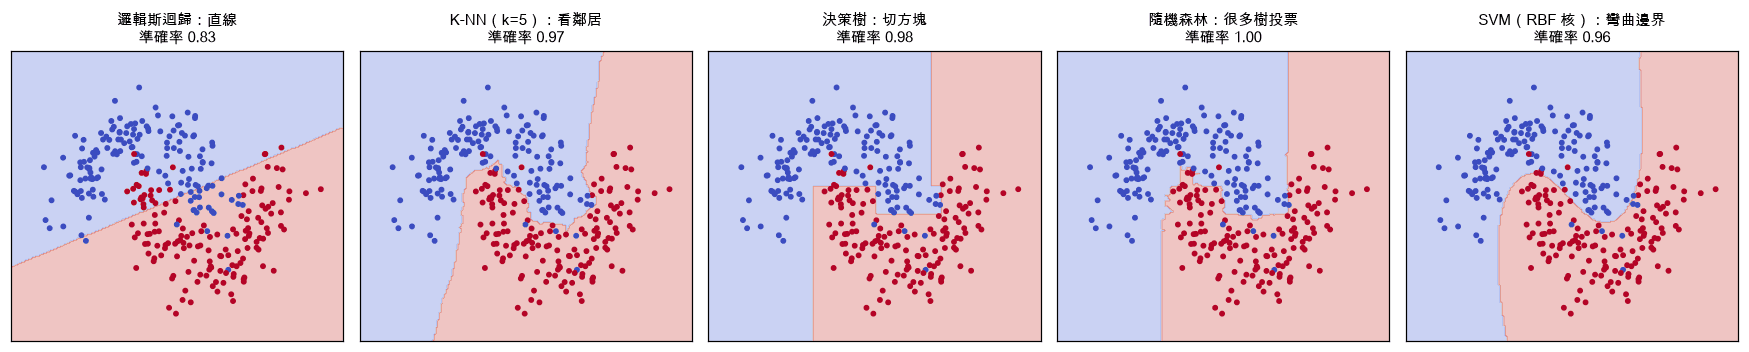
| 邏輯斯迴歸 | 畫一條直線分開 | 直線 | 要 | C(越小正則越強) |
| K-NN | 看最近 k 個鄰居投票 | 彎曲 | 一定要(用距離) | n_neighbors |
| 決策樹 | 一連串是非題 | 方塊 | 不用 | max_depth |
| 隨機森林 | 很多樹投票(bagging) | 方塊、較平滑 | 不用 | n_estimators、max_depth |
| Gradient Boosting | 一棵接一棵修正錯誤 | 方塊、較平滑 | 不用 | learning_rate、n_estimators |
| SVM | 找離兩邊最遠的邊界;核函數讓邊界彎曲 | 直線或彎曲 | 一定要 | C、kernel='rbf'、gamma |
跟著做
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifier

X, y = make_moons(500, noise=0.3, random_state=0)  # 兩個月牙形
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)
models = {
    '邏輯斯迴歸': make_pipeline(StandardScaler(), LogisticRegression()),
    'K-NN': make_pipeline(StandardScaler(), KNeighborsClassifier(15)),
    'SVM': make_pipeline(StandardScaler(), SVC()),
    '決策樹': DecisionTreeClassifier(max_depth=4, random_state=0),
    '隨機森林': RandomForestClassifier(200, max_depth=6, random_state=0),
    'Boosting': GradientBoostingClassifier(random_state=0),
}
for name, m in models.items():
    print(f'{name:6} {m.fit(X_train, y_train).score(X_test, y_test):.3f}')
# → 邏輯斯迴歸 0.813、K-NN 0.873、SVM 0.880、決策樹 0.880、隨機森林 0.893、Boosting 0.893
比賽提示
表格資料先試隨機森林或 Boosting 當基準線;資料少、特徵少時 SVM 常常很強;K-NN 和 SVM 忘了標準化會差很多。
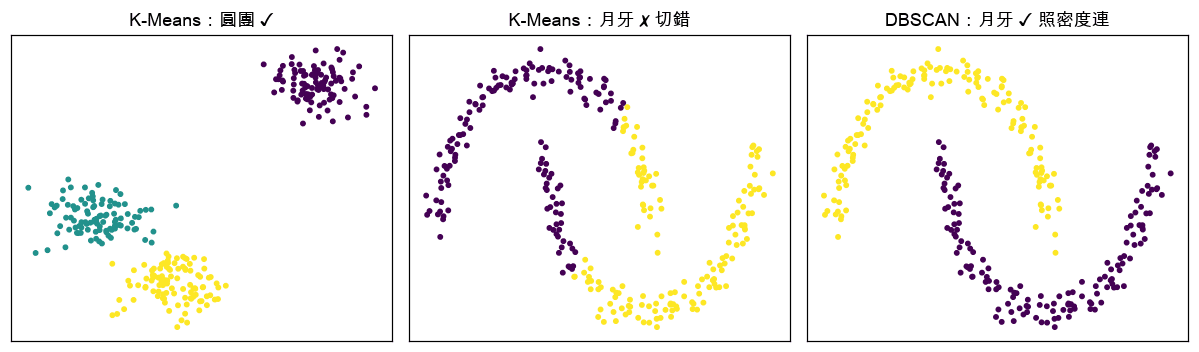
§4|分群:K-Means、DBSCAN、階層、譜分群
| 方法 | 一句話 | 要先給群數嗎 | 適合 | 不適合 |
|---|---|---|---|---|
| K-Means | 反覆把點分給最近的中心,再更新中心 | 要(k) | 圓團、大小相近 | 月牙、長條 |
| DBSCAN | 密的地方連成一群,稀的是雜訊 | 不用(給 eps 距離) | 任意形狀、有雜訊 | 密度差很多 |
| 階層分群 | 從每點一群開始,最近的兩群一直合併 | 可事後切 | 想看樹狀關係 | 資料很大 |
| 譜分群 | 先建「誰和誰相近」的圖再切 | 要 | 彎曲形狀 | 資料很大 |
| 均值漂移(fast.ai L12) | 每點往附近平均移動 | 不用 | 任意形狀 | 慢 |
跟著做
from sklearn.datasets import make_moons
from sklearn.cluster import KMeans, DBSCAN, AgglomerativeClustering, SpectralClustering
from sklearn.metrics import adjusted_rand_score

X, y = make_moons(300, noise=0.06, random_state=0)
for name, m in [('K-Means', KMeans(2, n_init=10, random_state=0)),
                ('DBSCAN', DBSCAN(eps=0.2)),
                ('階層', AgglomerativeClustering(2, linkage='single')),
                ('譜分群', SpectralClustering(2, affinity='nearest_neighbors', random_state=0))]:
    print(f'{name:8} 和正確答案的相似度 ARI = {adjusted_rand_score(y, m.fit_predict(X)):.2f}')
# → K-Means 0.23(切錯)、DBSCAN 1.00、階層 1.00、譜分群 0.87
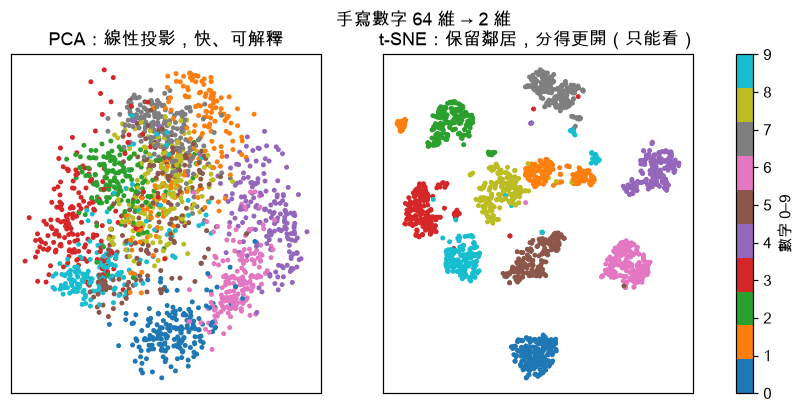
§5|降維:PCA、t-SNE、UMAP
| 方法 | 一句話 | 能用在新資料嗎 | 用途 |
|---|---|---|---|
| PCA | 找變化最大的方向投影過去(線性) | 能(transform) | 壓縮特徵、去雜訊、當特徵工程 |
| t-SNE | 讓原本相近的點在 2D 也相近 | 不能 | 只拿來看圖 |
| UMAP | 和 t-SNE 類似,更快,整體結構保留較好 | 能 | 看圖、也可當特徵 |
跟著做
from sklearn.datasets import load_digits
from sklearn.decomposition import PCA

X, y = load_digits(return_X_y=True)               # 1797 張 8×8 手寫數字 → 64 維
pca = PCA(n_components=0.95).fit(X)               # 留住 95% 的變化量
print(X.shape[1], '維 →', pca.n_components_, '維')   # → 64 維 → 29 維
print(pca.explained_variance_ratio_[:3].round(3)) # 前三個方向各占多少 → [0.149 0.136 0.118]
UMAP 要另外安裝:pip install umap-learn,用法 umap.UMAP(n_components=2).fit_transform(X)。
比賽提示
PCA 前一定要標準化(除非各欄單位相同,像像素)。t-SNE 的圖上「群和群的距離」沒有意義。
§6|評估指標:混淆矩陣、精確率、召回率、F1、ROC
| 指標 | 公式 | 白話 | 什麼時候最重要 |
|---|---|---|---|
| 準確率 Accuracy | (TP+TN) ÷ 全部 | 答對幾成 | 類別平衡時 |
| 精確率 Precision | TP ÷ (TP+FP) | 說「是」的裡面有幾成真的是 | 誤報代價高(垃圾郵件誤刪) |
| 召回率 Recall | TP ÷ (TP+FN) | 真的「是」的裡面抓到幾成 | 漏報代價高(癌症篩檢) |
| F1 | 2PR ÷ (P+R) | P 和 R 的調和平均 | 類別不平衡時 |
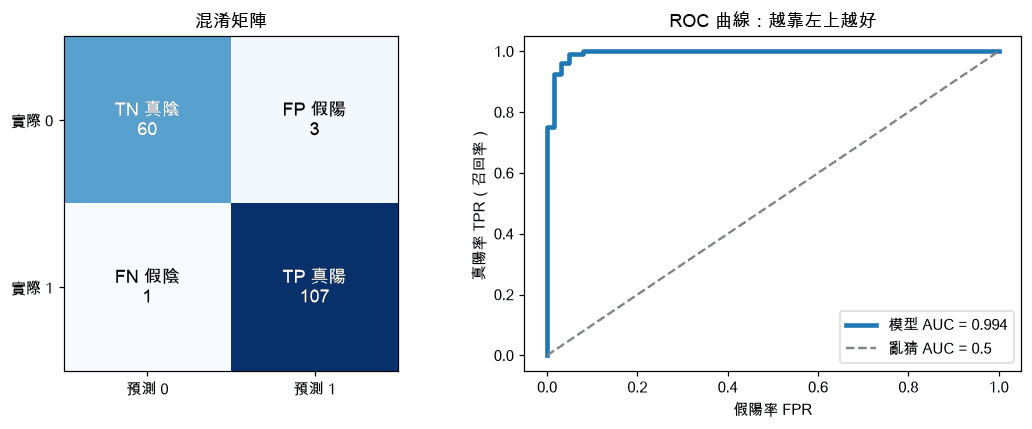
| ROC-AUC | ROC 曲線下面積 | 隨便抽一正一負,正的分數較高的機率 | 要比較模型,不想選門檻時 |
為什麼不能只看準確率
100 人裡 1 人有病,模型全部說「沒病」,準確率 99%,召回率 0%。
跟著做
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import confusion_matrix, classification_report, roc_auc_score

X, y = load_breast_cancer(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)
m = make_pipeline(StandardScaler(), LogisticRegression()).fit(X_train, y_train)
pred = m.predict(X_test)
print(confusion_matrix(y_test, pred))             # [[TN FP] [FN TP]] → [[60 3] [1 107]]
print(classification_report(y_test, pred, digits=3))
print('AUC', round(roc_auc_score(y_test, m.predict_proba(X_test)[:, 1]), 3))   # → AUC 0.994
手算練習
TP = 40、FP = 10、FN = 20、TN = 30。算出準確率、精確率、召回率、F1。
答案
準確率 = 70 ÷ 100 = 0.70;精確率 = 40 ÷ 50 = 0.80;召回率 = 40 ÷ 60 = 0.67;F1 = 2 × 0.8 × 0.67 ÷ 1.47 = 0.73
§7|交叉驗證與超參數調整
| 方法 | 做法 | 用途 |
|---|---|---|
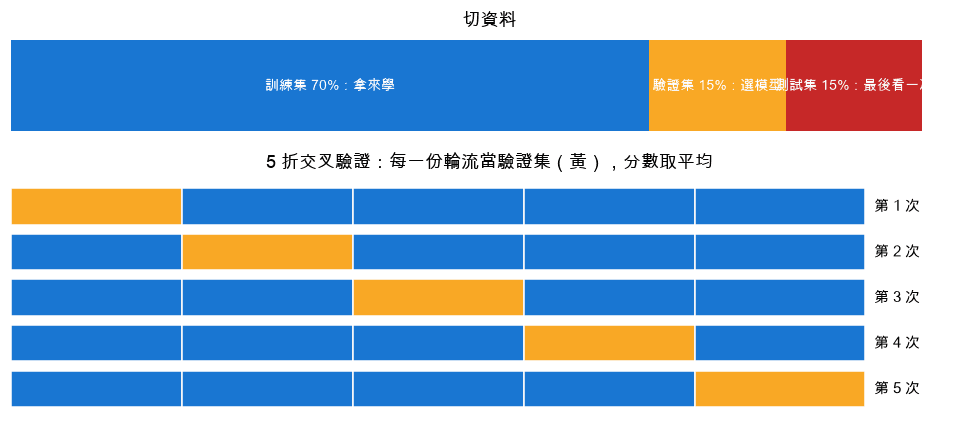
| 訓練/驗證/測試切分 | 70/15/15 | 最基本 |
| K 折交叉驗證 | 切 K 份,輪流當驗證集,取平均 | 資料少時估計更穩 |
| 分層(Stratified) | 每一折類別比例一樣 | 類別不平衡 |
| 時間序列切分 | 只用過去預測未來 | 有時間順序的資料(不能打亂) |
| Grid Search | 把參數組合全部試一次 | 參數少 |
| Random Search | 隨機抽組合試 | 參數多,通常更有效率 |
跟著做
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import cross_val_score, GridSearchCV
from sklearn.ensemble import RandomForestClassifier

X, y = load_breast_cancer(return_X_y=True)
scores = cross_val_score(RandomForestClassifier(random_state=0), X, y, cv=5)
print(scores.round(3), '平均', scores.mean().round(3))   # → 平均 0.963

grid = GridSearchCV(RandomForestClassifier(random_state=0),
                    {'n_estimators': [50, 200], 'max_depth': [3, None]}, cv=5)
grid.fit(X, y)
print(grid.best_params_, round(grid.best_score_, 3))   # → {'max_depth': None, 'n_estimators': 50} 0.963
比賽提示
調參數只能看驗證分數。偷看測試集調參數=作弊,分數會虛高。
§8|特徵工程與資料前處理
大綱特別列出的技巧:
| 問題 | 技巧 | 程式 |
|---|---|---|
| 缺值(數字) | 補平均或中位數 | SimpleImputer(strategy='median') |
| 缺值(類別) | 補眾數(fast.ai L05) | df.fillna(df.mode().iloc[0]) |
| 缺值(時間序列) | 用前一個值往前填 | df.ffill() |
| 類別欄位 | One-hot 編碼 | pd.get_dummies(df, columns=['性別']) |
| 數值大小差很多 | 標準化(平均 0、標準差 1) | StandardScaler() |
| 想壓到 0 到 1 | 正規化 | MinMaxScaler() |
| 長尾數字(票價、收入) | 取 log | np.log1p(x) |
| 時間序列 | 滑動視窗統計 | s.rolling(7).mean()、.std() |
| 長短不一的序列 | 補零到一樣長(padding) | nn.utils.rnn.pad_sequence |
| 高維資料 | PCA 或神經網路嵌入 | 見 §5、fast.ai L07 |
| 圖片切成小塊 | Patching(ViT 的做法) | x.unfold(...) |
跟著做
import numpy as np
import pandas as pd

df = pd.DataFrame({'年齡': [22, np.nan, 35, 58],
                   '城市': ['澳門', '香港', np.nan, '澳門'],
                   '票價': [7.25, 71.3, 8.05, 512.3]})
df['年齡'] = df['年齡'].fillna(df['年齡'].median())    # 缺值補中位數 → 35.0
df['城市'] = df['城市'].fillna(df['城市'].mode()[0])    # 補眾數 → 澳門
df['log票價'] = np.log1p(df['票價'])                    # 長尾取 log
df = pd.get_dummies(df, columns=['城市'], dtype=int)   # one-hot
print(df.round(2))

s = pd.Series([3, 5, 4, 6, 8, 7, 9])
print(s.rolling(3).mean().tolist())   # 滑動平均 → [nan, nan, 4.0, 5.0, 6.0, 7.0, 8.0]
比賽提示
前處理的參數(平均、中位數)只能用訓練集算,再套到驗證和測試集,否則就是資料外洩。用 Pipeline 包起來最安全。
自我檢核
- 用四步套路訓練任一 scikit-learn 模型
- 說出 L1 和 L2 的差別,各舉一個用途
- 哪兩個模型一定要先標準化?為什麼?
- 月牙形資料用哪個分群方法?
- t-SNE 能不能拿來轉換測試資料?
- 從混淆矩陣手算精確率、召回率、F1
- 時間序列資料為什麼不能隨機切分?
- 為什麼前處理只能用訓練集的統計值?
答案提示(先自己想再點開)
3 是 K-NN 和 SVM(靠距離);5 不能;7 會用未來資料預測過去;8 避免資料外洩。
