IOAI 圖解速查|公式、圖、一行程式
大綱「理論+實作」類題目的考前速查:激活函數、損失函數、梯度下降、過擬合、卷積池化、注意力、優化器、正則化。每項一張圖、一個公式、一行 PyTorch。
IOAI 圖解速查
🏠 IOAI 總覽 | ← 視覺語言音訊 | 圖表重製程式 →
圖 1|激活函數
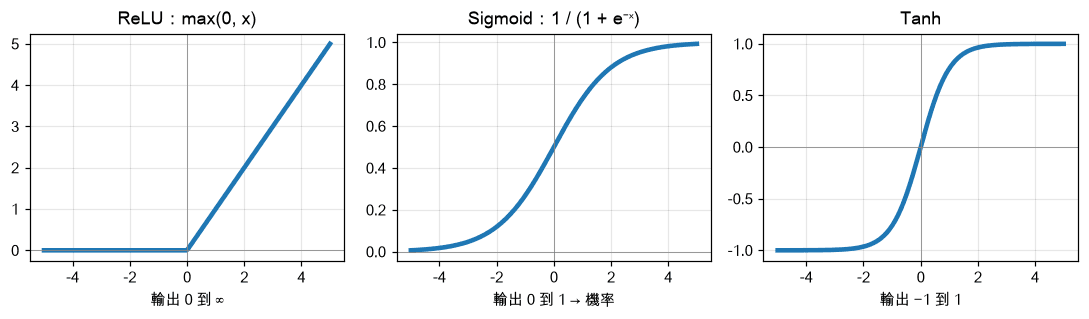
| 函數 | 公式 | 輸出範圍 | PyTorch | 用在哪 | 陷阱 |
|---|---|---|---|---|---|
| ReLU | max(0, x) | 0 到 ∞ | F.relu(x) | 隱藏層預設 | 負數梯度是 0(神經元可能「死掉」) |
| Sigmoid | 1 ÷ (1 + e⁻ˣ) | 0 到 1 | torch.sigmoid(x) | 二元分類的輸出 | 兩端很平,梯度消失 |
| Tanh | (eˣ − e⁻ˣ) ÷ (eˣ + e⁻ˣ) | −1 到 1 | torch.tanh(x) | RNN | 同上 |
| Softmax | eˣⁱ ÷ Σeˣʲ | 0 到 1,加總 = 1 | F.softmax(x, dim=-1) | 多類別分類的輸出 | 要指定 dim |
圖 2|損失函數
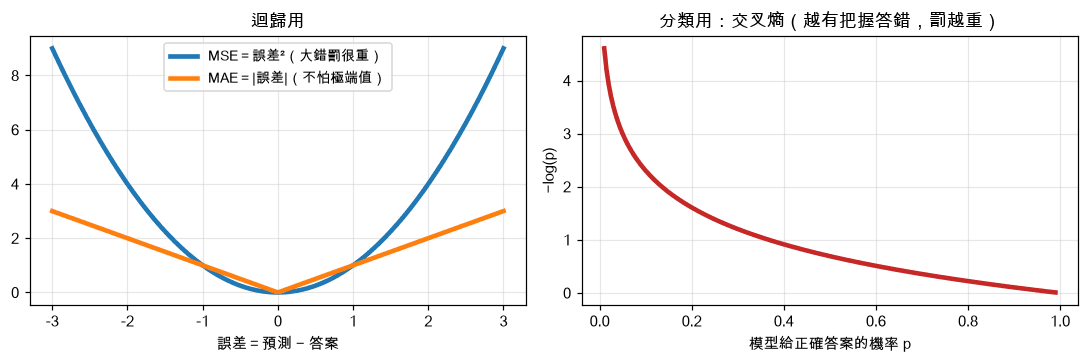
| 損失 | 公式 | 任務 | PyTorch | 陷阱 |
|---|---|---|---|---|
| MSE | 平均(預測 − 答案)² | 迴歸 | F.mse_loss(p, y) | 對極端值很敏感 |
| MAE | 平均 |預測 − 答案| | 迴歸,有極端值 | F.l1_loss(p, y) | 在 0 不可微 |
| 二元交叉熵 | −[y·log p + (1−y)·log(1−p)] | 二元分類 | F.binary_cross_entropy_with_logits(z, y) | 輸入是 sigmoid 之前的分數 |
| 交叉熵 | −log(正確類別的機率) | 多類別分類 | F.cross_entropy(z, y) | 輸入是 softmax 之前的分數,不要自己先做 softmax |
圖 3|梯度下降與學習率
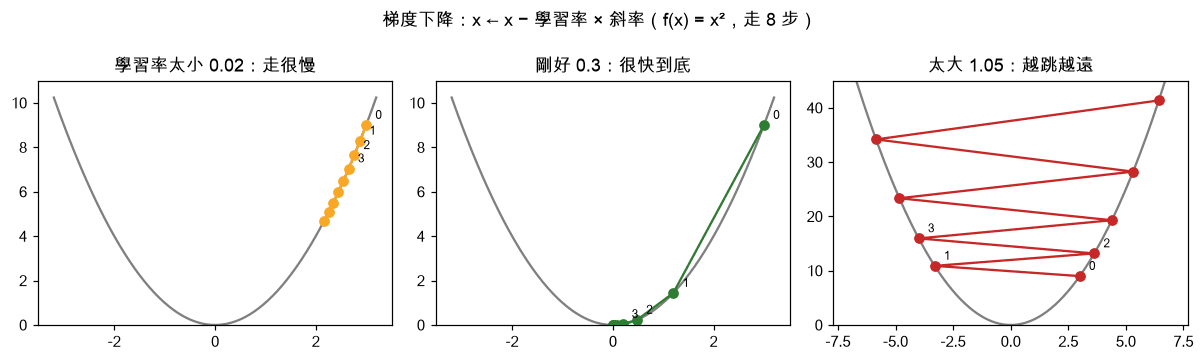
| 項目 | 內容 |
|---|---|
| 更新公式 | w ← w − 學習率 × ∂損失/∂w |
| PyTorch 三步 | loss.backward() 算梯度 → opt.step() 走一步 → opt.zero_grad() 清掉梯度 |
| 學習率太小 | 損失下降很慢 |
| 學習率太大 | 損失震盪或變成 nan |
| 怎麼找 | fast.ai lr_find()(L16):選損失下降最陡的地方 |
| 變形 | 每次用多少資料算梯度 | 特色 |
|---|---|---|
| 批次梯度下降 | 全部 | 穩但慢 |
| SGD | 1 筆 | 快但很吵 |
| 小批次 | 32 到 512 筆 | 實際上都用這個 |
手算練習
損失 L = (w − 3)²,w = 5,學習率 0.1。走一步之後 w 是多少?
答案
斜率 = 2(w − 3) = 4;新的 w = 5 − 0.1 × 4 = 4.6
圖 4|優化器
| 優化器 | 一句話 | PyTorch | 何時用 |
|---|---|---|---|
| SGD | 照梯度走 | optim.SGD(params, lr=0.1) | 基準 |
| SGD + Momentum | 帶慣性,像球滾下坡 | optim.SGD(params, lr=0.1, momentum=0.9) | CNN 常用 |
| Adam | 動量 + 每個參數自己的學習率 | optim.Adam(params, lr=1e-3) | 不知道用什麼就用它 |
| AdamW | Adam + 正確的 weight decay | optim.AdamW(params, lr=1e-3, weight_decay=0.01) | Transformer、微調 |
對應 fast.ai L18。
圖 5|欠擬合、過擬合、早停
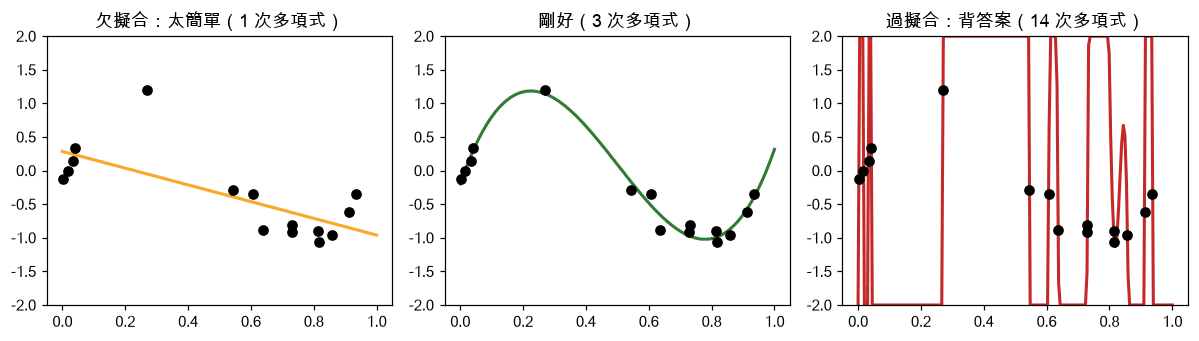
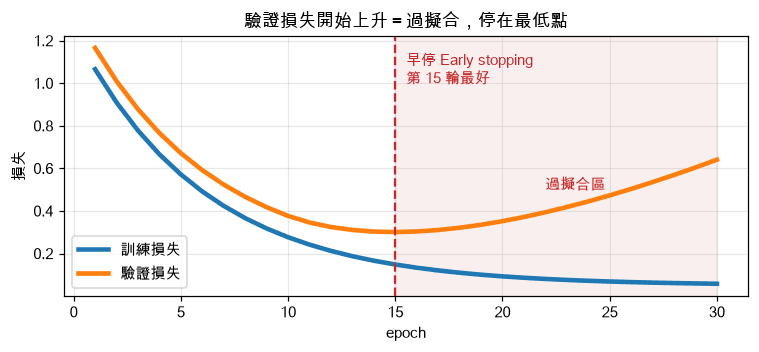
| 症狀 | 訓練損失 | 驗證損失 | 解法 |
|---|---|---|---|
| 欠擬合 | 高 | 高 | 模型加大、訓練更久、加特徵 |
| 剛好 | 低 | 低 | 保持 |
| 過擬合 | 很低 | 先降後升 | 更多資料、資料增強、Dropout、weight decay、早停、模型變小 |
圖 6|卷積與池化
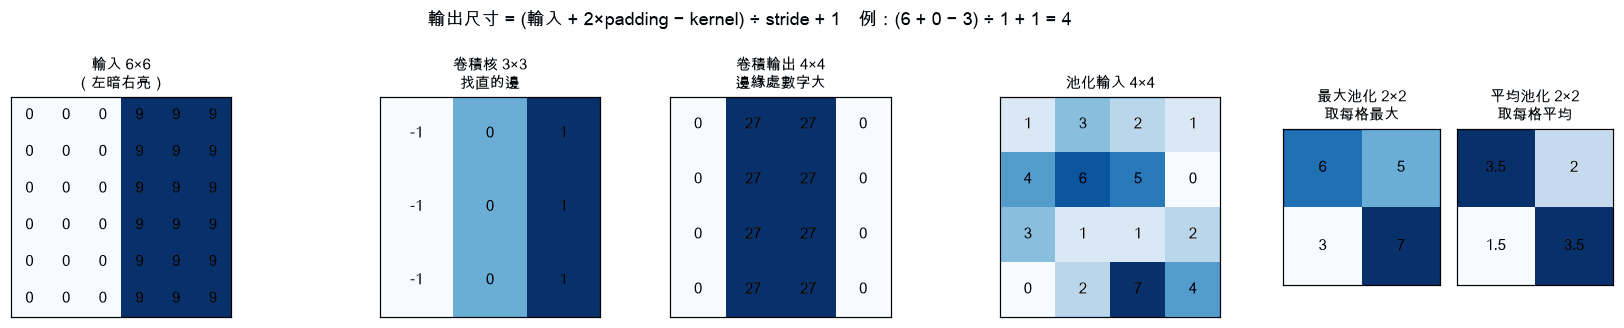
| 項目 | 公式或程式 |
|---|---|
| 輸出邊長 | ⌊(輸入 + 2 × padding − kernel) ÷ stride⌋ + 1 |
| 參數數量 | (kernel × kernel × 輸入通道 + 1) × 輸出通道 |
| 卷積層 | nn.Conv2d(in_ch, out_ch, kernel_size=3, stride=1, padding=1) |
| 最大池化 | nn.MaxPool2d(2):邊長減半 |
| 平均池化 | nn.AvgPool2d(2);全域平均 nn.AdaptiveAvgPool2d(1) |
手算練習
輸入 28×28,Conv2d(3, 16, kernel_size=3, stride=2, padding=1)。輸出邊長和參數數量各是多少?
答案
邊長 = ⌊(28 + 2 − 3) ÷ 2⌋ + 1 = 14;參數 = (3 × 3 × 3 + 1) × 16 = 448
用程式驗證手算
import torch, torch.nn as nn                 # 驗證手算
conv = nn.Conv2d(3, 16, kernel_size=3, stride=2, padding=1)
print(conv(torch.zeros(1, 3, 28, 28)).shape)            # → torch.Size([1, 16, 14, 14])
print(sum(p.numel() for p in conv.parameters()))       # → 448
圖 7|注意力與 Transformer
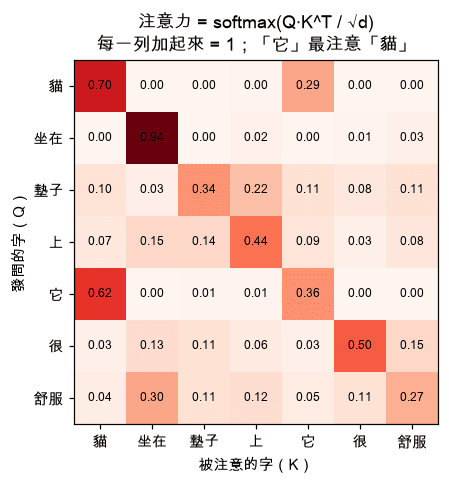
| 項目 | 內容 |
|---|---|
| 公式 | Attention(Q, K, V) = softmax(Q·Kᵀ ÷ √d) · V |
| Q、K、V | 同一句話的嵌入乘上三個不同的權重矩陣 |
| 為什麼除 √d | 不除的話數字太大,softmax 變得太尖 |
| 多頭 | 同時做好幾組注意力,各自注意不同關係 |
| 位置編碼 | 注意力本身不知道字的順序,要另外加位置資訊 |
| Transformer 一層 | 注意力 → 加回輸入(殘差)→ LayerNorm → MLP → 殘差 → LayerNorm |
| 圖片怎麼用 | 切成 16×16 小方塊(patch),每塊當一個字(ViT) |
跟著做
import torch, torch.nn.functional as F       # 注意力一行版
Q = K = V = torch.randn(1, 5, 8)            # 1 句、5 個字、每字 8 維
A = F.softmax(Q @ K.transpose(-2, -1) / 8 ** 0.5, dim=-1)
print(A.sum(-1))                            # 每一列加起來 = 1 → tensor([[1., 1., 1., 1., 1.]])
print((A @ V).shape)                        # → torch.Size([1, 5, 8])
對應 fast.ai L24。
圖 8|正則化總表
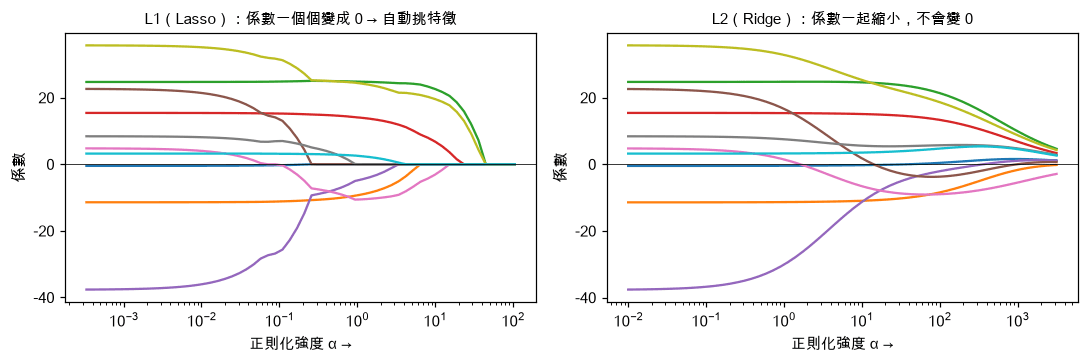
| 方法 | 程式 | 一句話 |
|---|---|---|
| L2 / weight decay | AdamW(..., weight_decay=0.01) | 權重不要太大 |
| L1 | Lasso(alpha=) | 權重變成 0 |
| Dropout | nn.Dropout(0.5) | 訓練時隨機關掉;model.eval() 時全開 |
| BatchNorm | nn.BatchNorm2d(c) | 每層輸入平均 0、標準差 1(L17) |
| 資料增強 | aug_transforms()(L02) | 讓資料變多樣 |
| 早停 | 留驗證損失最低的那一版 | 不讓它過擬合 |
圖 9|評估、分群、降維
詳細說明在 經典機器學習補缺。
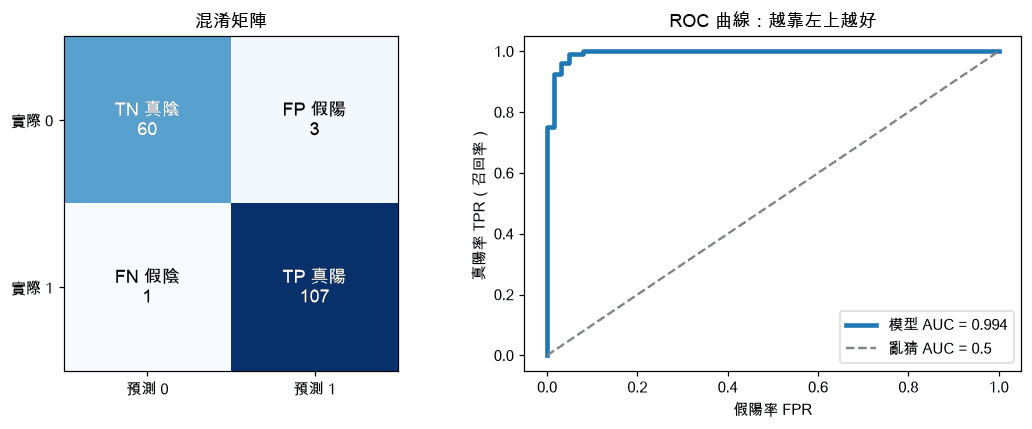
混淆矩陣與 ROC(§6)
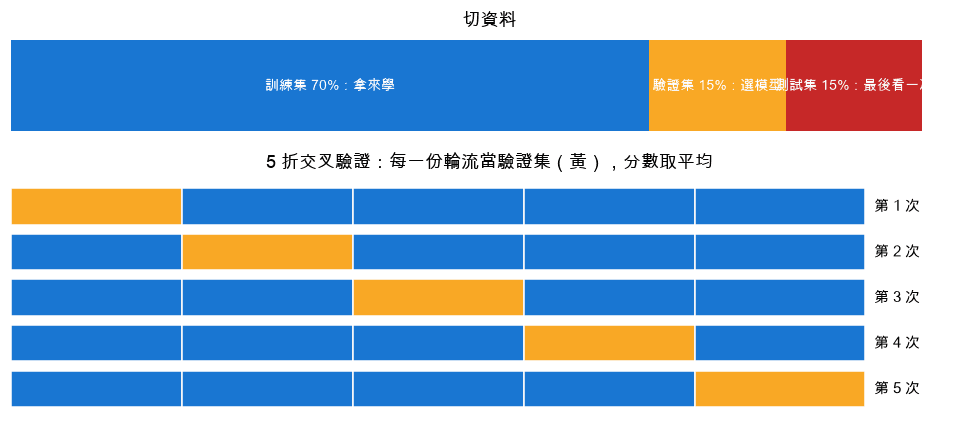
切資料與交叉驗證(§7)
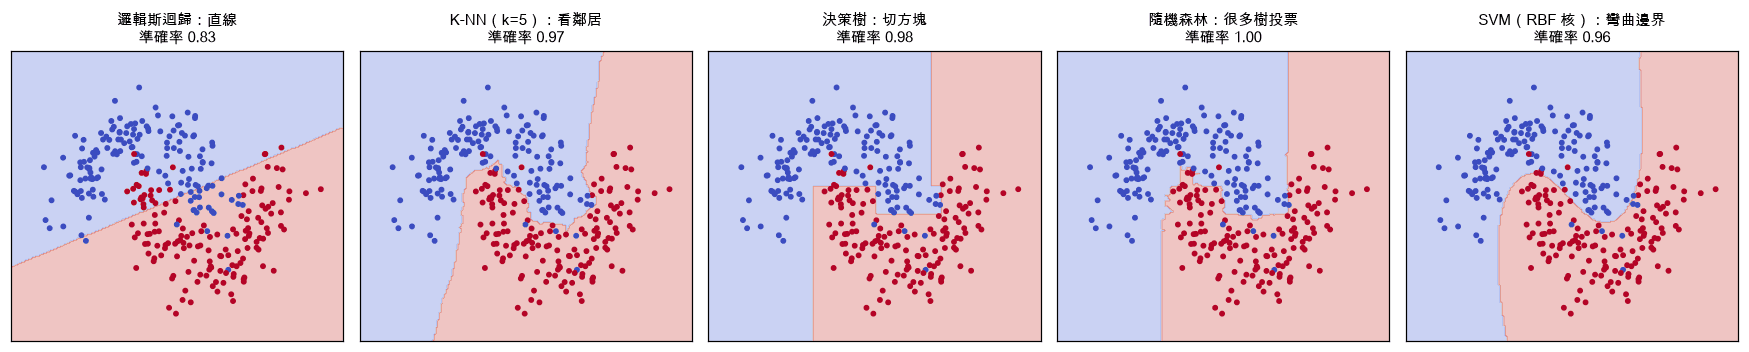
五種分類器的決策邊界(§3)
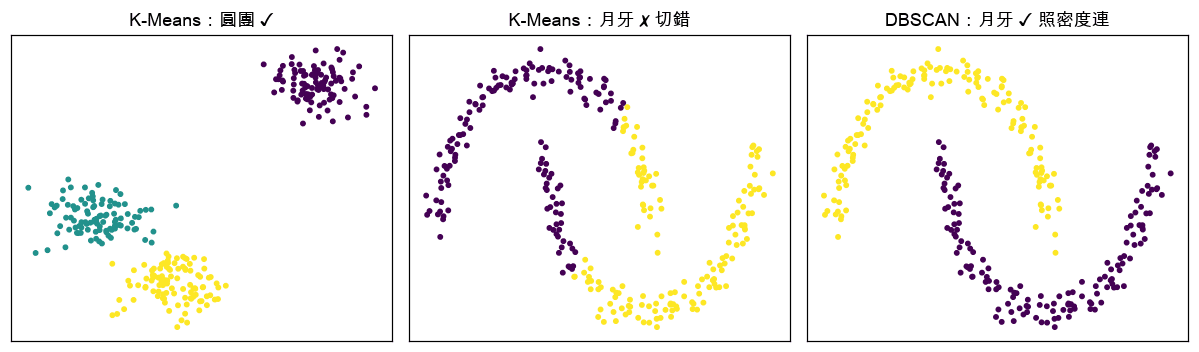
K-Means 與 DBSCAN(§4)
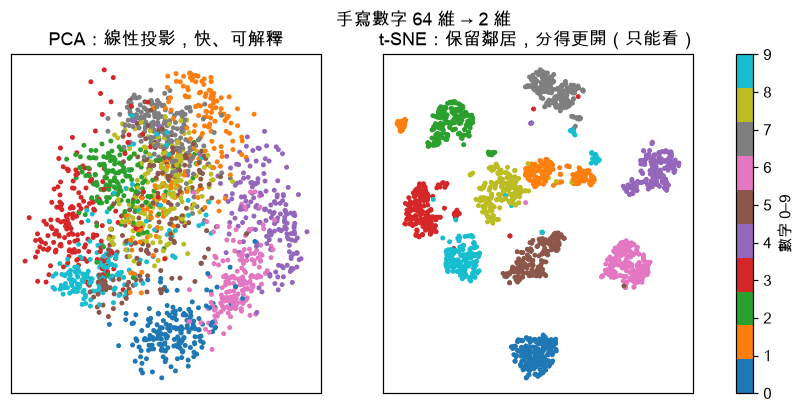
PCA 與 t-SNE(§5)
考前 10 題
先自己回答,再點開看答案。
1. 多類別分類的最後一層和損失?
線性層輸出分數,F.cross_entropy(內含 softmax)
2. 損失變成 nan,最可能原因?
學習率太大
3. 訓練準確率 99%、驗證 70%?
過擬合
4. 28×28 經過 MaxPool2d(2) 兩次?
7×7
5. model.eval() 會改變哪兩種層?
Dropout、BatchNorm
6. Adam 和 AdamW 差在哪?
weight decay 的加法方式
7. 注意力為什麼要除以 √d?
避免 softmax 太尖、梯度太小
8. 為什麼用預訓練模型?
已學會通用特徵,少量資料就能微調
9. ReLU 比 sigmoid 好在哪?
正數區梯度不會消失、計算快
10. 不平衡資料只看準確率的問題?
全猜多數類也很高,要看召回率、F1
